Investigación independiente · Actualizado en octubre de 2026

Inteligencia de Modelos, Benchmarks y Carreras Tech Globales

Comparativas rigurosas de más de 330 modelos de IA, análisis de costos de API, datos salariales de ingeniería y guías de inmigración verificadas.

Comparativas y herramientas

Modelos de IA analizados

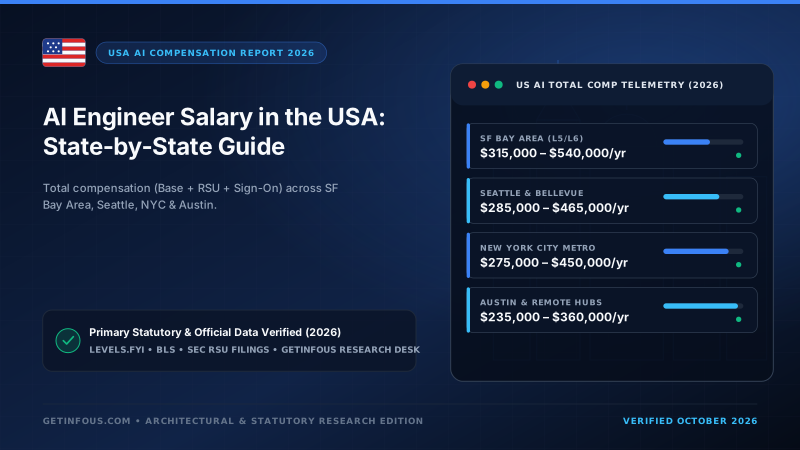
Salario medio Ing. EE. UU.

Idiomas soportados

Directorio de Modelos y Herramientas

Explora Modelos Frontera, Agentes de Código y Herramientas

Filter by category — foundation models, code assistants, image generators, video engines, and autonomous workflows.

Precio:

Mostrando 12 herramientas de IA seleccionadas

Código y Desarrollo
HotFreemium

Cursor AI

4.9
The AI-first code editor built for lightning software development

A VS Code fork embedded with powerful frontier models that can write, refactor, and debug code across your entire repository with multi-file awareness.

Multi-file editsRepo-wide indexTab autocompletionClaude 3.5 Sonnet
LLMs y Escritura
PopularFreemium

Claude 3.5 Sonnet

4.9
The industry-leading model for reasoning, coding and complex nuance

Anthropic flagship intelligence model known for superior coding benchmarks, deep nuanced writing, and the interactive Artifacts workspace.

Interactive Artifacts200K token contextLeading coding benchmarksVision
LLMs y Escritura
PopularFreemium

ChatGPT (GPT-4o)

4.8
The versatile multimodal intelligence engine by OpenAI

Omni-model integrating voice, vision, and text in real time. Powers advanced web browsing, Python code execution, and custom GPT assistants.

Voice modeAdvanced Data AnalysisDALL·E 3 Image GenerationCustom GPTs
Productividad y Agentes
TrendingFreemium

Perplexity AI

4.9
Conversational answer engine with direct citations from the live web

Replaces standard search engines with synthesized answers, cited sources, real-time follow-ups, and multi-file document analysis.

Real-time web searchInline source citationsFocus modesPro search
Imagen y Arte
PopularDe pago

Midjourney v6

4.9
Photorealistic image generation and artistic visual synthesis

The gold standard in text-to-image AI, renowned for exceptional texture realism, coherent lighting, fine typographic generation, and web canvas editing.

Photorealism v6Inpainting & OutpaintingWeb interfaceStyle reference
Imagen y Arte
HotFreemium

FLUX.1 by Black Forest Labs

4.8
Open-weight generative imaging model redefining text rendering and anatomy

Cutting-edge 12B parameter flow matching visual model rivaling Midjourney with state-of-the-art hand anatomy, prompt adherence, and open weights.

Open-weight variantsFlawless text in imagesPhotorealistic handsFast inference

Datos de Benchmarks

Modelos Frontera — Comparación Directa

Compare context windows, coding benchmarks, reasoning scores, and API pricing across providers.

Frontier ModelContext WindowSWE-bench (Code)HumanEvalPricingIdeal Use Case
Claude 3.7 Sonnet Top Score
Anthropic
200,000 tokens70.3% (Verified)93.7%$3 / $15 per 1M tokensHybrid reasoning with thinking mode, complex multi-file code editing, and precise refactoring.
GPT-4o
OpenAI
128,000 tokens38.8%90.2%$2.50 / $10 per 1M tokensReal-time voice, vision analysis, structured outputs, and general conversational intelligence.
DeepSeek R1
DeepSeek
128,000 tokens49.2%92.8%$0.55 / $2.19 per 1M tokensDeep chain-of-thought reasoning, mathematical proofs, and competitive programming.
Gemini 2.0 Flash
Google
1,000,000 tokens24.1%84.1%$0.10 / $0.40 per 1M tokensUltra-fast inference, massive document processing, and cost-efficient high-throughput workloads.

Methodology

How We Score, Measure, and Price Every Model

Published so you can audit any number on this site — no black-box composite scores.

¿Cómo se calcula el índice de inteligencia?

El índice de inteligencia es una puntuación compuesta de 0 a 100 que combina diez evaluaciones independientes: SWE-bench Verified para programación agéntica, GPQA Diamond para ciencia avanzada, MMLU-Pro, AIME para matemáticas, HumanEval, LiveCodeBench, Terminal-Bench, Humanity’s Last Exam, recuperación de contexto largo y LMArena Elo.

¿Cómo se mide la velocidad de salida?

La velocidad se mide en tokens de salida por segundo en estado estable a través de la API oficial de cada proveedor, promediada en veinte solicitudes consecutivas con un prompt fijo de 1,000 tokens, junto con la latencia hasta el primer token (TTFT).

¿Cómo se calcula el costo por tarea?

El costo por tarea modela una carga de trabajo agéntica realista de 45,000 tokens de salida con 10,000 tokens de contexto de entrada, aplicando los precios oficiales por millón de tokens de cada proveedor.

¿De dónde provienen los datos de referencia (benchmarks)?

Cada cifra proviene de especificaciones oficiales de lanzamiento, tarjetas de modelos (model cards) y ejecuciones de evaluación reproducidas de forma independiente.

¿Con qué frecuencia se actualiza la clasificación?

Los precios y la disponibilidad se verifican semanalmente, y las puntuaciones de referencia se actualizan cada vez que un proveedor lanza una nueva versión o al menos una vez al mes.

Carreras e Inmigración

Guías e Investigación en Profundidad

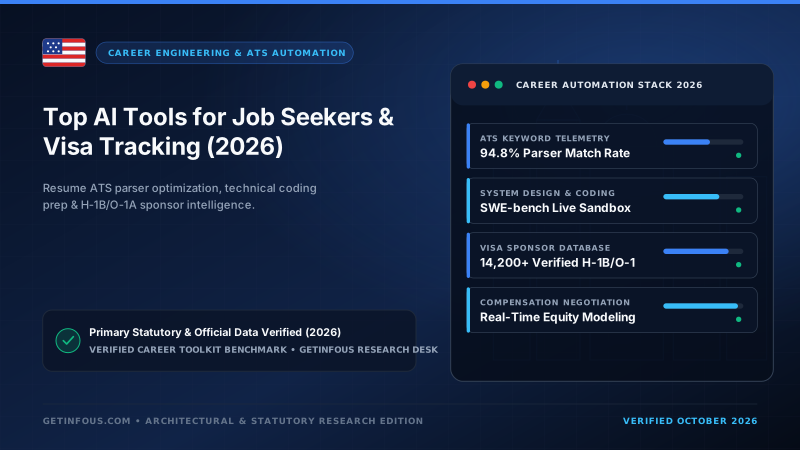
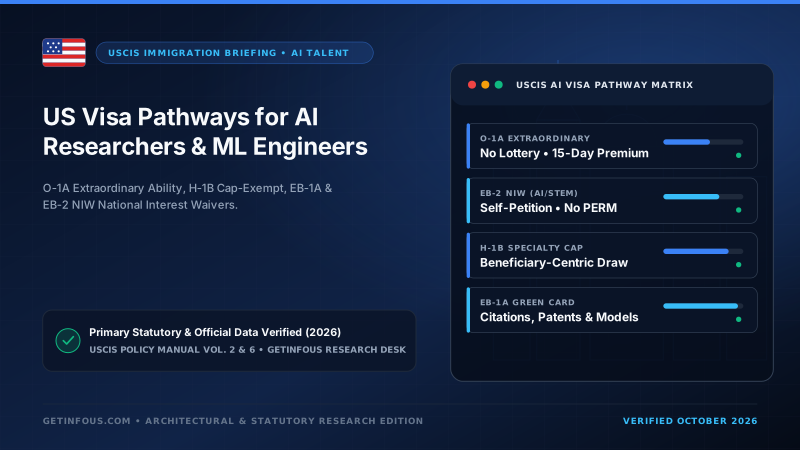
Salary breakdowns by US state, immigration pathways for engineers, and interview preparation.

Todos los artículos

Boletín Semanal de Inteligencia

Model releases, pricing changes, benchmark updates, and career data — one email per week.

No spam. Unsubscribe with one click.