Jamba 1.5 Large vs Jamba 1.5 Mini
Benchmarks, API Token Pricing, Context Window & Speed Comparison
Related topics (12)
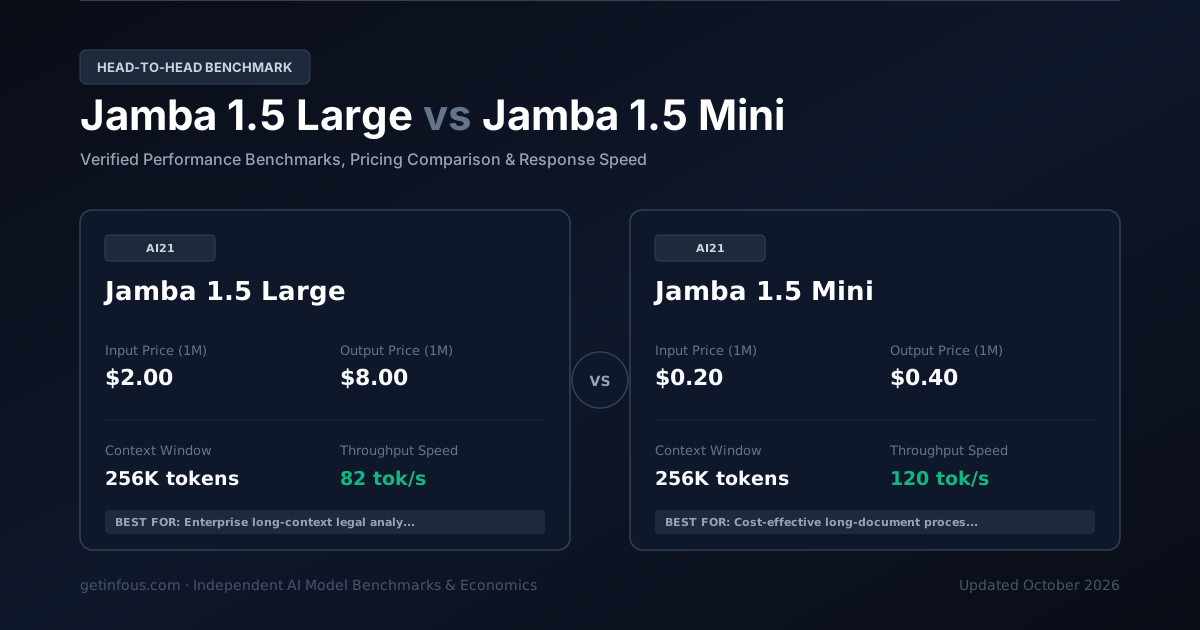
Jamba 1.5 Large de AI21 et Jamba 1.5 Mini de AI21 sont deux modèles d’IA de premier plan. Jamba 1.5 Large propose une fenêtre de contexte de 256K tokens au tarif de $2.00/$8.00 par million de tokens, tandis que Jamba 1.5 Mini offre 256K tokens de contexte à $0.20/$0.40 par million de tokens. Découvrez ci-dessous le comparatif détaillé des performances et des coûts.
Changez et Comparez les Modèles
Select any AI models from our verified benchmark database to generate live side-by-side matrices.
Jamba 1.5 Large
Modèle de Base à Poids OuvertsJamba 1.5 Large de AI21 est un modèle d’IA conçu pour l’auto-hébergement sur infrastructure privée, le fine-tuning et la souveraineté des données, offrant une fenêtre de contexte de 256K, une vitesse de 82 tokens/s, un indice d’intelligence
$2.00 / 1M
$8.00 / 1M
256K tokens
41.2%
Jamba 1.5 Mini
Inférence Ultra-RapideJamba 1.5 Mini de AI21 est un modèle d’IA conçu pour les applications en temps réel à très faible latence et le routage à haut débit, offrant une fenêtre de contexte de 256K, une vitesse de 120 tokens/s, un indice d’intelligence de 39/100 e
$0.20 / 1M
$0.40 / 1M
256K tokens
35.8%
Différences Clés en un Coup d’Œil
- Jamba 1.5 Mini is 14.9x cheaper for API usage (input + output tokens combined).
- Jamba 1.5 Mini is faster at 120 tok/s vs 82 tok/s.
- Jamba 1.5 Large leads on SWE-bench coding (41.2% vs 35.8%).
| Caractéristique | Jamba 1.5 Large | Jamba 1.5 Mini |
|---|---|---|
Intelligence Index Composite reasoning & knowledge score (0-100) | 42 | 39 |
Provider | AI21 | AI21 |
Input Price Cost per million input tokens | $2.00 / 1M | $0.20 / 1M |
Output Price Cost per million output tokens | $8.00 / 1M | $0.40 / 1M |
Blended Price Weighted 7:2:1 cache:input:output per 1M | $1.55 / 1M | $0.11 / 1M |
Context Window Maximum input + output tokens | 256K tokens~384 A4 pages of text | 256K tokens~384 A4 pages of text |
Max Output Tokens Per single request | 4K | 4K |
Throughput Speed Tokens generated per second | 82 tok/s | 120 tok/s |
SWE-bench Verified Real-world software engineering | 41.2% | 35.8% |
GPQA Diamond Graduate-level reasoning | 51% | 44.2% |
Cached Input Price Prompt caching discount per 1M tokens | $0.50 / 1M | $0.05 / 1M |
Qui gagne où ?
At-a-glance decision frameworkScores de Benchmarks Vérifiés
Official evaluation metrics verified by independent third-party research labs.
Industry benchmark evaluating real-world GitHub issue resolution and multi-file debugging.
Challenging questions created by domain experts to test complex PhD-level reasoning.
Hardened reasoning and academic knowledge benchmark with reduced lucky-guess probability.
Crowdsourced human preference evaluation based on blind, head-to-head model battles.
Extremely difficult, closed-ended questions spanning the frontier of human expert knowledge.
Autonomous multi-step tasks executed inside a real command-line terminal environment.
Research-grade coding problems drawn from real scientific and numerical workloads.
Contamination-free competitive programming problems collected continuously over time.
American Invitational Mathematics Examination — multi-step Olympiad-level reasoning.
Accuracy when reasoning over very large inputs that fill the model context window.
Tokens emitted per second during active generation streaming.
Latence et Temps de Réponse
Time to first token (TTFT) and estimated end-to-end response time for a typical 500-token response.
Simulateur Interactif de Coût de Tokens
Adjust sliders to calculate projected monthly cloud API spending with prompt caching discounts.
Jamba 1.5 Large · Strengths & Key Advantages
- Fenêtre de contexte de 256K et capacité de sortie maximale de 4K tokens (SWE-bench Verified 41.2% · GPQA Diamond 51%)
- Débit rapide de 82 tokens/seconde avec une latence au premier token (TTFT) de 490 ms
- Poids ouverts (398B (94B )) permettant un déploiement sur site ou cloud privé via vLLM, SGLang ou Ollama
Considerations & Trade-offs
- Nécessite des serveurs GPU dotés de suffisamment de mémoire VRAM pour l’inférence locale à pleine précision
- Pour les charges à très fort volume, l’activation du cache de prompts et de l’API Batch est recommandée
Jamba 1.5 Mini · Strengths & Key Advantages
- Fenêtre de contexte de 256K et capacité de sortie maximale de 4K tokens (SWE-bench Verified 35.8% · GPQA Diamond 44.2%)
- Débit rapide de 120 tokens/seconde avec une latence au premier token (TTFT) de 340 ms
- Poids ouverts (52B (12B )) permettant un déploiement sur site ou cloud privé via vLLM, SGLang ou Ollama
Considerations & Trade-offs
- Nécessite des serveurs GPU dotés de suffisamment de mémoire VRAM pour l’inférence locale à pleine précision
- Sur les problèmes de recherche fondamentale très complexes, les modèles de raisonnement lourd restent supérieurs
Token Use & Task Economics
Estimated cost and token consumption to complete one representative agentic task.
| Metric | Jamba 1.5 Large | Jamba 1.5 Mini |
|---|---|---|
Cost per Task Estimated USD to finish one task | $0.48 | $0.12 |
Output Tokens / Task Tokens generated per task | 25K | 20K |
Reasoning Tokens / Task Thinking tokens burned per task | 0K | 0K |
Spécifications Techniques
Architecture, release timeline, capabilities, and modalities.
| Caractéristique | Jamba 1.5 Large | Jamba 1.5 Mini |
|---|---|---|
| Official API Model ID (SDK) | jamba-1-5-large | jamba-1-5-mini |
| API Protocol | OpenAI-Compatible REST / vLLM / SGLang / HuggingFace TGI | OpenAI-Compatible REST / vLLM / SGLang / HuggingFace TGI |
| Release Date | 2024-08 | 2024-08 |
| Knowledge Cutoff | March 2024 | March 2024 |
| Architecture | Hybrid SSM-Transformer (Mamba + Transformer MoE) | Hybrid SSM-Transformer (Mamba + Transformer MoE) |
| Parameters | 398B (94B active) | 52B (12B active) |
| Enterprise Rate Limits (RPM / TPM) | Unlimited (Hardware-bound on self-hosted GPU) / 10,000 RPM Cloud · Unlimited local throughput / 10M+ TPM Managed Cloud | Unlimited (Hardware-bound on self-hosted GPU) / 10,000 RPM Cloud · Unlimited local throughput / 10M+ TPM Managed Cloud |
| Long-Context Tier (>128K/200K) | Flat rate ($2/1M in) across full 256K window | Flat rate ($0.2/1M in) across full 256K window |
| Prompt Cache Policy & TTL | Cached input at $0.5/1M tokens | Cached input at $0.05/1M tokens |
| Computer Use / GUI Agent | API / CLI Tool-Use & DOM Agent ready (no raw pixel desktop click loop) | API / CLI Tool-Use & DOM Agent ready (no raw pixel desktop click loop) |
| MCP & Parallel Tool Calling | Native MCP Client/Server ready · Parallel function calling · 100% Strict JSON Schema | Native MCP Client/Server ready · Parallel function calling · 100% Strict JSON Schema |
| Web Search Grounding & Sandbox | Supported via external Tavily/Exa Search & E2B/Docker Sandbox tools | Supported via external Tavily/Exa Search & E2B/Docker Sandbox tools |
| Official Fine-Tuning Support | Full Weights SFT, LoRA, QLoRA, DPO & GRPO RL (Unsloth / Axolotl / Llama-Factory) | Full Weights SFT, LoRA, QLoRA, DPO & GRPO RL (Unsloth / Axolotl / Llama-Factory) |
| Multimodal Token Billing | Text BPE (~4 chars/token) | Text BPE (~4 chars/token) |
| Quantization & Min GPU VRAM | BF16 / FP16, FP8 Dynamic, INT4 AWQ / GPTQ, GGUF (Q4_K_M / Q8_0) · 247 GB VRAM (4-bit Quantized) · 856 GB VRAM (Native BF16) | BF16 / FP16, FP8 Dynamic, INT4 AWQ / GPTQ, GGUF (Q4_K_M / Q8_0) · 32 GB VRAM (4-bit Quantized) · 112 GB VRAM (Native BF16) |
| Safety & Frontier Classification | Open-Weights System Card + Customizable Guardrail Layer (Llama Guard / ShieldGemma) | Open-Weights System Card + Customizable Guardrail Layer (Llama Guard / ShieldGemma) |
| Enterprise Compliance (ZDR/HIPAA/SOC2) | 100% Air-Gapped On-Premises / Private VPC · Full HIPAA, GDPR & SOC2 Control | 100% Air-Gapped On-Premises / Private VPC · Full HIPAA, GDPR & SOC2 Control |
| Input Modalities | text | text |
| Output Modalities | text | text |
Jamba 1.5 Large vs Jamba 1.5 Mini: Réponses Rapides (FAQ)
Which is more intelligent, Jamba 1.5 Large or Jamba 1.5 Mini?
Jamba 1.5 Large is more intelligent. It scores 42 compared with 39 on the composite Intelligence Index.
Which model is faster?
Jamba 1.5 Mini is faster, generating 120 tokens per second compared with 82 tokens per second.
Which model is cheaper to run?
Jamba 1.5 Mini is cheaper at $0.11 per 1M tokens blended, compared with $1.55 (7:2:1 cache:input:output ratio).
Which model has lower latency?
Jamba 1.5 Mini has lower latency, with a time to first token of 0.34s compared with 0.49s.
Verdict
Jamba 1.5 Large (Conçu pour l’auto-hébergement sur infrastructure privée, le fine-tuning et la souveraineté des données, l’intégration RAG et les pipelines de production évolutifs.) et Jamba 1.5 Mini (Conçu pour les applications en temps réel à très faible latence et le routage à haut débit, l’intégration RAG et les pipelines de production évolutifs.) répondent à des besoins complémentaires : Jamba 1.5 Large domine sur les benchmarks de raisonnement et de programmation, Jamba 1.5 Mini assure un débit supérieur et Jamba 1.5 Mini offre le meilleur rapport coût-efficacité en production.
Questions fréquentes
Quel modèle choisir pour le code et le raisonnement, Jamba 1.5 Large ou Jamba 1.5 Mini ?+
Sur l’indice d’intelligence composite et les tests de code, Jamba 1.5 Large prend l’avantage. Consultez les scores SWE-bench et GPQA ci-dessus pour plus de détails.
Quelle est la différence de prix API entre Jamba 1.5 Large et Jamba 1.5 Mini ?+
Jamba 1.5 Large est facturé $2.00 / $8.00 par million de tokens (entrée/sortie) contre $0.20 / $0.40 pour Jamba 1.5 Mini. En coût pondéré, Jamba 1.5 Mini est plus économique.
Quel modèle offre la plus grande fenêtre de contexte et la meilleure vitesse ?+
Jamba 1.5 Large prend en charge 256K tokens contre 256K tokens pour Jamba 1.5 Mini. Côté vitesse de génération, Jamba 1.5 Mini est le plus rapide.
Understand key metrics like context window, token pricing, reasoning mode, and SWE-bench scores in our comprehensive AI glossary.
Related reading
- Command R+ vs Jamba 1.5 Large : Comparatif Benchmarks, Tarifs API et Vitesse (2026)Comparer
- Command R vs Jamba 1.5 Mini : Comparatif Benchmarks, Tarifs API et Vitesse (2026)Comparer
- Aion-3.0 vs Aion-Mini : Comparatif Benchmarks, Tarifs API et Vitesse (2026)Comparer
- Aion-3.0 vs Gemini 3.6 Flash : Comparatif Benchmarks, Tarifs API et Vitesse (2026)Comparer
- Aion-Mini vs Laguna XS 2.1 : Comparatif Benchmarks, Tarifs API et Vitesse (2026)Comparer
- Aya Expanse 32B vs Llama 3.2 90B Vision : Comparatif Benchmarks, Tarifs API et Vitesse (2026)Comparer
Les scores de benchmarks, tarifs par token et limites évoluent rapidement. Vérifiez toujours les spécifications actuelles sur la documentation officielle du fournisseur.
Sources: Documentation API officielle de AI21 et AI21, fiches système et benchmarks indépendants (2026).