Gemma 4 E4B vs Gemma 4 E2B
Benchmarks, API Token Pricing, Context Window & Speed Comparison
Related topics (12)
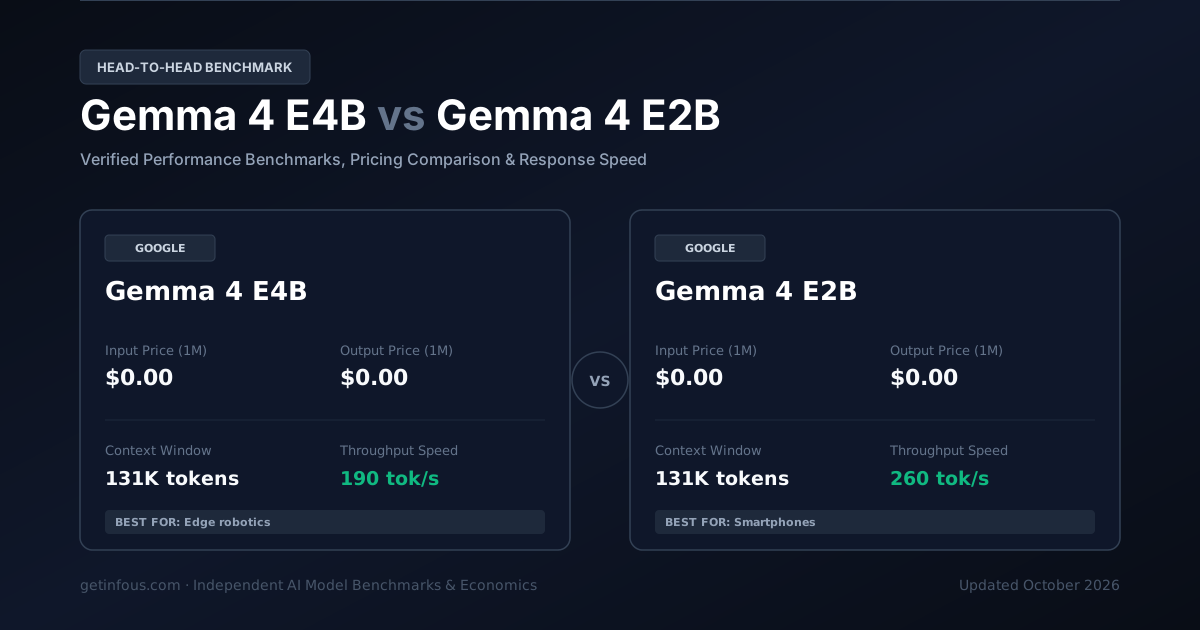
Gemma 4 E4B de Google et Gemma 4 E2B de Google sont deux modèles d’IA de premier plan. Gemma 4 E4B propose une fenêtre de contexte de 131.1K tokens au tarif de $0.00/$0.00 par million de tokens, tandis que Gemma 4 E2B offre 131.1K tokens de contexte à $0.00/$0.00 par million de tokens. Découvrez ci-dessous le comparatif détaillé des performances et des coûts.
Changez et Comparez les Modèles
Select any AI models from our verified benchmark database to generate live side-by-side matrices.
Gemma 4 E4B
Modèle de Base à Poids OuvertsGemma 4 E4B de Google est un modèle d’IA conçu pour l’auto-hébergement sur infrastructure privée, le fine-tuning et la souveraineté des données, offrant une fenêtre de contexte de 131K, une vitesse de 190 tokens/s, un indice d’intelligence
$0.00 / 1M
$0.00 / 1M
131.1K tokens
N/A
Gemma 4 E2B
Modèle de Base à Poids OuvertsGemma 4 E2B de Google est un modèle d’IA conçu pour l’auto-hébergement sur infrastructure privée, le fine-tuning et la souveraineté des données, offrant une fenêtre de contexte de 131K, une vitesse de 260 tokens/s, un indice d’intelligence
$0.00 / 1M
$0.00 / 1M
131.1K tokens
N/A
Différences Clés en un Coup d’Œil
- Both models cost the same under this workload — choose on capability, not price.
- Gemma 4 E2B is faster at 260 tok/s vs 190 tok/s.
| Caractéristique | Gemma 4 E4B | Gemma 4 E2B |
|---|---|---|
Intelligence Index Composite reasoning & knowledge score (0-100) | 65 | 55 |
Provider | ||
Input Price Cost per million input tokens | $0.00 / 1M | $0.00 / 1M |
Output Price Cost per million output tokens | $0.00 / 1M | $0.00 / 1M |
Blended Price Weighted 7:2:1 cache:input:output per 1M | $0.00 / 1M | $0.00 / 1M |
Context Window Maximum input + output tokens | 131.1K tokens~197 A4 pages of text | 131.1K tokens~197 A4 pages of text |
Max Output Tokens Per single request | 16K | 8K |
Throughput Speed Tokens generated per second | 190 tok/s | 260 tok/s |
SWE-bench Verified Real-world software engineering | N/A | N/A |
Qui gagne où ?
At-a-glance decision frameworkEvaluations ongoing
Scores de Benchmarks Vérifiés
Official evaluation metrics verified by independent third-party research labs.
Hardened reasoning and academic knowledge benchmark with reduced lucky-guess probability.
Crowdsourced human preference evaluation based on blind, head-to-head model battles.
Tokens emitted per second during active generation streaming.
Latence et Temps de Réponse
Time to first token (TTFT) and estimated end-to-end response time for a typical 500-token response.
Simulateur Interactif de Coût de Tokens
Adjust sliders to calculate projected monthly cloud API spending with prompt caching discounts.
Gemma 4 E4B · Strengths & Key Advantages
- Fenêtre de contexte de 131K et capacité de sortie maximale de 16K tokens (MMLU-Pro 74% · Arena Elo 1320)
- Débit rapide de 190 tokens/seconde avec une latence au premier token (TTFT) de 220 ms
- Poids ouverts (E4B (4B)) permettant un déploiement sur site ou cloud privé via vLLM, SGLang ou Ollama
Considerations & Trade-offs
- Nécessite des serveurs GPU dotés de suffisamment de mémoire VRAM pour l’inférence locale à pleine précision
- Sur les problèmes de recherche fondamentale très complexes, les modèles de raisonnement lourd restent supérieurs
Gemma 4 E2B · Strengths & Key Advantages
- Fenêtre de contexte de 131K et capacité de sortie maximale de 8K tokens (MMLU-Pro 67.2% · Arena Elo 1260)
- Débit rapide de 260 tokens/seconde avec une latence au premier token (TTFT) de 180 ms
- Poids ouverts (E2B (2B)) permettant un déploiement sur site ou cloud privé via vLLM, SGLang ou Ollama
Considerations & Trade-offs
- Nécessite des serveurs GPU dotés de suffisamment de mémoire VRAM pour l’inférence locale à pleine précision
- Sur les problèmes de recherche fondamentale très complexes, les modèles de raisonnement lourd restent supérieurs
Token Use & Task Economics
Estimated cost and token consumption to complete one representative agentic task.
| Metric | Gemma 4 E4B | Gemma 4 E2B |
|---|---|---|
Cost per Task Estimated USD to finish one task | $0.00 | $0.00 |
Output Tokens / Task Tokens generated per task | 4K | 2K |
Reasoning Tokens / Task Thinking tokens burned per task | 1K | 1K |
Spécifications Techniques
Architecture, release timeline, capabilities, and modalities.
| Caractéristique | Gemma 4 E4B | Gemma 4 E2B |
|---|---|---|
| Official API Model ID (SDK) | models/gemma-4-e4b | models/gemma-4-e2b |
| API Protocol | Google Gemini API (generateContent) + OpenAI-Compatible SDK | Google Gemini API (generateContent) + OpenAI-Compatible SDK |
| Release Date | 2026-04 | 2026-04 |
| Knowledge Cutoff | January 2026 | January 2026 |
| Architecture | Edge-optimized dense open transformer | Ultra-compact edge transformer |
| Parameters | E4B (4B) | E2B (2B) |
| Enterprise Rate Limits (RPM / TPM) | Unlimited (Hardware-bound on self-hosted GPU) / 10,000 RPM Cloud · Unlimited local throughput / 10M+ TPM Managed Cloud | Unlimited (Hardware-bound on self-hosted GPU) / 10,000 RPM Cloud · Unlimited local throughput / 10M+ TPM Managed Cloud |
| Long-Context Tier (>128K/200K) | Free across full context window (only KV-cache VRAM scales) | Free across full context window (only KV-cache VRAM scales) |
| Prompt Cache Policy & TTL | Automatic prefix KV-caching in vLLM / SGLang (0 cost) | Automatic prefix KV-caching in vLLM / SGLang (0 cost) |
| Computer Use / GUI Agent | Supported (Screen coordinate grounding, browser & desktop GUI action loops) | Supported (Screen coordinate grounding, browser & desktop GUI action loops) |
| MCP & Parallel Tool Calling | Native MCP Client/Server ready · Parallel function calling · 100% Strict JSON Schema | Native MCP Client/Server ready · Parallel function calling · 100% Strict JSON Schema |
| Web Search Grounding & Sandbox | Built-in Google Search Grounding + Managed Python Code Execution Sandbox | Built-in Google Search Grounding + Managed Python Code Execution Sandbox |
| Official Fine-Tuning Support | Full Weights SFT, LoRA, QLoRA, DPO & GRPO RL (Unsloth / Axolotl / Llama-Factory) | Full Weights SFT, LoRA, QLoRA, DPO & GRPO RL (Unsloth / Axolotl / Llama-Factory) |
| Multimodal Token Billing | Text BPE (~4 chars/token) · Vision (~258–765 tokens per image tile) | Text BPE (~4 chars/token) · Vision (~258–765 tokens per image tile) |
| Quantization & Min GPU VRAM | BF16 / FP16, FP8 Dynamic, INT4 AWQ / GPTQ, GGUF (Q4_K_M / Q8_0) · 2 GB VRAM (4-bit Quantized) · 9 GB VRAM (Native BF16) | BF16 / FP16, FP8 Dynamic, INT4 AWQ / GPTQ, GGUF (Q4_K_M / Q8_0) · 2 GB VRAM (4-bit Quantized) · 4 GB VRAM (Native BF16) |
| Safety & Frontier Classification | Google DeepMind Frontier Safety Framework Verified | Google DeepMind Frontier Safety Framework Verified |
| Enterprise Compliance (ZDR/HIPAA/SOC2) | 100% Air-Gapped On-Premises / Private VPC · Full HIPAA, GDPR & SOC2 Control | 100% Air-Gapped On-Premises / Private VPC · Full HIPAA, GDPR & SOC2 Control |
| Input Modalities | text, vision | text, vision |
| Output Modalities | text | text |
Gemma 4 E4B vs Gemma 4 E2B: Réponses Rapides (FAQ)
Which is more intelligent, Gemma 4 E4B or Gemma 4 E2B?
Gemma 4 E4B is more intelligent. It scores 65 compared with 55 on the composite Intelligence Index.
Which model is faster?
Gemma 4 E2B is faster, generating 260 tokens per second compared with 190 tokens per second.
Which model has lower latency?
Gemma 4 E2B has lower latency, with a time to first token of 0.18s compared with 0.22s.
Verdict
Gemma 4 E4B (Conçu pour l’auto-hébergement sur infrastructure privée, le fine-tuning et la souveraineté des données, l’intégration RAG et les pipelines de production évolutifs.) et Gemma 4 E2B (Conçu pour l’auto-hébergement sur infrastructure privée, le fine-tuning et la souveraineté des données, l’intégration RAG et les pipelines de production évolutifs.) répondent à des besoins complémentaires : Gemma 4 E4B domine sur les benchmarks de raisonnement et de programmation, Gemma 4 E2B assure un débit supérieur et Gemma 4 E4B offre le meilleur rapport coût-efficacité en production.
Questions fréquentes
Quel modèle choisir pour le code et le raisonnement, Gemma 4 E4B ou Gemma 4 E2B ?+
Sur l’indice d’intelligence composite et les tests de code, Gemma 4 E4B prend l’avantage. Consultez les scores SWE-bench et GPQA ci-dessus pour plus de détails.
Quelle est la différence de prix API entre Gemma 4 E4B et Gemma 4 E2B ?+
Gemma 4 E4B est facturé $0.00 / $0.00 par million de tokens (entrée/sortie) contre $0.00 / $0.00 pour Gemma 4 E2B. En coût pondéré, Gemma 4 E4B est plus économique.
Quel modèle offre la plus grande fenêtre de contexte et la meilleure vitesse ?+
Gemma 4 E4B prend en charge 131.1K tokens contre 131.1K tokens pour Gemma 4 E2B. Côté vitesse de génération, Gemma 4 E2B est le plus rapide.
Understand key metrics like context window, token pricing, reasoning mode, and SWE-bench scores in our comprehensive AI glossary.
Related reading
- DeepSeek V4 vs Gemma 4 E2B : Comparatif Benchmarks, Tarifs API et Vitesse (2026)Comparer
- Gemma 4 E2B vs Gemma 4 31B : Comparatif Benchmarks, Tarifs API et Vitesse (2026)Comparer
- Gemma 4 E4B vs Hy3 preview : Comparatif Benchmarks, Tarifs API et Vitesse (2026)Comparer
- Aion-3.0 vs Aion-Mini : Comparatif Benchmarks, Tarifs API et Vitesse (2026)Comparer
- Aion-3.0 vs Gemini 3.6 Flash : Comparatif Benchmarks, Tarifs API et Vitesse (2026)Comparer
- Aion-Mini vs Laguna XS 2.1 : Comparatif Benchmarks, Tarifs API et Vitesse (2026)Comparer
Les scores de benchmarks, tarifs par token et limites évoluent rapidement. Vérifiez toujours les spécifications actuelles sur la documentation officielle du fournisseur.
Sources: Documentation API officielle de Google et Google, fiches système et benchmarks indépendants (2026).