Llama 3.2 3B vs Qwen 2.5 72B
বেঞ্চমার্ক, এপিআই টোকেন মূল্য, কনটেক্সট উইন্ডো এবং ইনফারেন্স স্পিড তুলনা
Related topics (12)
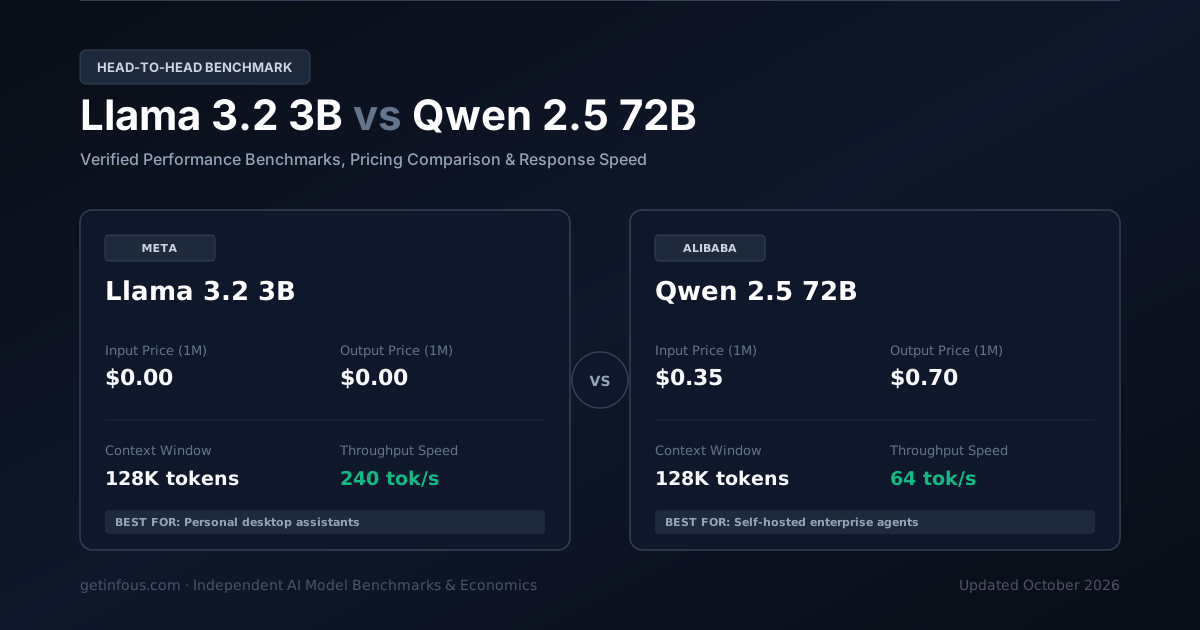
Meta-এর Llama 3.2 3B এবং Alibaba-এর Qwen 2.5 72B হলো দুটি শীর্ষস্থানীয় এআই মডেল। Llama 3.2 3B মডেলে রয়েছে 128K টোকেন কনটেক্সট উইন্ডো এবং এর এপিআই মূল্য $0.00/$0.00 প্রতি ১ মিলিয়ন টোকেন, যেখানে Qwen 2.5 72B মডেলে রয়েছে 128K টোকেন কনটেক্সট এবং মূল্য $0.35/$0.70 প্রতি ১ মিলিয়ন টোকেন। নিচে উভয় মডেলের বেঞ্চমার্ক, গতি ও খরচের বিস্তারিত তুলনা দেওয়া হলো।
যেকোনো দুটি এআই মডেল পরিবর্তন ও তুলনা করুন
আমাদের যাচাইকৃত বেঞ্চমার্ক ডাটাবেস থেকে যেকোনো এআই মডেল নির্বাচন করে তাৎক্ষণিক তুলনা দেখুন।
Llama 3.2 3B
ওপেন-ওয়েটস ফাউন্ডেশন মডেলMeta-এর Llama 3.2 3B হলো সেলফ-হোস্টিং, ফাইন-টিউনিং এবং প্রাইভেট ক্লাউড ডিপ্লয়মেন্টের জন্য উন্মুক্ত ওপেন-ওয়েটস এআই মডেল, যা 128K কনটেক্সট উইন্ডো, 240 টোকেন/সেকেন্ড স্পিড এবং বিনামূল্যে ওপেন-ওয়েটস অ্যাক্সেস 52/100 ইন্টেলিজেন্স স্কোর প্রদান
$0.00 / 1M
$0.00 / 1M
128K tokens
N/A
Qwen 2.5 72B
ওপেন-ওয়েটস ফাউন্ডেশন মডেলAlibaba-এর Qwen 2.5 72B হলো সেলফ-হোস্টিং, ফাইন-টিউনিং এবং প্রাইভেট ক্লাউড ডিপ্লয়মেন্টের জন্য উন্মুক্ত ওপেন-ওয়েটস এআই মডেল, যা 128K কনটেক্সট উইন্ডো, 64 টোকেন/সেকেন্ড স্পিড এবং $0.35/$0.7 প্রতি 1M টোকেন মূল্যে 44/100 ইন্টেলিজেন্স স্কোর প্রদ
$0.35 / 1M
$0.70 / 1M
128K tokens
45.2%
একনজরে প্রধান পার্থক্যসমূহ
- Llama 3.2 3B is 1.0x cheaper for API usage (input + output tokens combined).
- Llama 3.2 3B is faster at 240 tok/s vs 64 tok/s.
| বৈশিষ্ট্য | Llama 3.2 3B | Qwen 2.5 72B |
|---|---|---|
Intelligence Index Composite reasoning & knowledge score (0-100) | 52 | 44 |
Provider | Meta | Alibaba |
Input Price Cost per million input tokens | $0.00 / 1M | $0.35 / 1M |
Output Price Cost per million output tokens | $0.00 / 1M | $0.70 / 1M |
Blended Price Weighted 7:2:1 cache:input:output per 1M | $0.00 / 1M | $0.19 / 1M |
Context Window Maximum input + output tokens | 128K tokens~192 A4 pages of text | 128K tokens~192 A4 pages of text |
Max Output Tokens Per single request | 4K | 8K |
Throughput Speed Tokens generated per second | 240 tok/s | 64 tok/s |
SWE-bench Verified Real-world software engineering | N/A | 45.2% |
GPQA Diamond Graduate-level reasoning | N/A | 52.8% |
Cached Input Price Prompt caching discount per 1M tokens | $0.00 / 1M | $0.07 / 1M |
কোন ক্ষেত্রে কোন মডেল সেরা?
একনজরে সিদ্ধান্ত নেওয়ার ফ্রেমওয়ার্কEvaluations ongoing
যাচাইকৃত বেঞ্চমার্ক স্কোর তুলনা
স্বাধীন গবেষণা ল্যাব দ্বারা যাচাইকৃত অফিশিয়াল ইভ্যালুয়েশন মেট্রিক্স।
Industry benchmark evaluating real-world GitHub issue resolution and multi-file debugging.
Challenging questions created by domain experts to test complex PhD-level reasoning.
Hardened reasoning and academic knowledge benchmark with reduced lucky-guess probability.
Crowdsourced human preference evaluation based on blind, head-to-head model battles.
Extremely difficult, closed-ended questions spanning the frontier of human expert knowledge.
Autonomous multi-step tasks executed inside a real command-line terminal environment.
Research-grade coding problems drawn from real scientific and numerical workloads.
Contamination-free competitive programming problems collected continuously over time.
American Invitational Mathematics Examination — multi-step Olympiad-level reasoning.
Accuracy when reasoning over very large inputs that fill the model context window.
Tokens emitted per second during active generation streaming.
লেটেন্সি ও রেসপন্স টাইম
প্রথম টোকেন আসার সময় (TTFT) এবং ৫০০ টোকেনের রেসপন্স জেনারেট করতে আনুমানিক সময়।
রিয়েল-টাইম টোকেন খরচ সিমুলেটর
প্রম্পট ক্যাশিং ডিসকাউন্টসহ মাসিক ক্লাউড API খরচ হিসাব করতে স্লাইডার পরিবর্তন করুন।
Llama 3.2 3B · শক্তি ও প্রধান সুবিধাসমূহ
- 128K কনটেক্সট উইন্ডো এবং সর্বোচ্চ 4K আউটপুট টোকেন জেনারেশন সক্ষমতা (MMLU-Pro 56.5% · Arena Elo 1190)
- 240 টোকেন/সেকেন্ড জেনারেশন স্পিড এবং মাত্র 160ms প্রথম টোকেন ল্যাটেন্সি (TTFT)
- ওপেন-ওয়েটস আর্কিটেকচার (3B) — vLLM, Ollama বা প্রাইভেট GPU ক্লাস্টারে সেলফ-হোস্টিংযোগ্য
বিবেচ্য বিষয় ও সীমাবদ্ধতা
- সম্পূর্ণ প্রিসিশনে লোকাল GPU সার্ভারে হোস্ট করতে পর্যাপ্ত VRAM ও হার্ডওয়্যার অবকাঠামো প্রয়োজন
- অত্যন্ত জটিল মাল্টি-হপ গবেষণার ক্ষেত্রে ফ্ল্যাগশিপ রিজনিং মডেলের তুলনায় নির্ভুলতা কিছুটা কম হতে পারে
Qwen 2.5 72B · শক্তি ও প্রধান সুবিধাসমূহ
- 128K কনটেক্সট উইন্ডো এবং সর্বোচ্চ 8K আউটপুট টোকেন জেনারেশন সক্ষমতা (SWE-bench Verified 45.2% · GPQA Diamond 52.8%)
- 64 টোকেন/সেকেন্ড জেনারেশন স্পিড এবং মাত্র 610ms প্রথম টোকেন ল্যাটেন্সি (TTFT)
- ওপেন-ওয়েটস আর্কিটেকচার (72B) — vLLM, Ollama বা প্রাইভেট GPU ক্লাস্টারে সেলফ-হোস্টিংযোগ্য
বিবেচ্য বিষয় ও সীমাবদ্ধতা
- সম্পূর্ণ প্রিসিশনে লোকাল GPU সার্ভারে হোস্ট করতে পর্যাপ্ত VRAM ও হার্ডওয়্যার অবকাঠামো প্রয়োজন
- অত্যন্ত জটিল মাল্টি-হপ গবেষণার ক্ষেত্রে ফ্ল্যাগশিপ রিজনিং মডেলের তুলনায় নির্ভুলতা কিছুটা কম হতে পারে
টোকেন ব্যবহার ও টাস্ক ইকোনমিক্স
একটি স্ট্যান্ডার্ড এজেন্টিক টাস্ক সম্পন্ন করতে আনুমানিক খরচ এবং টোকেন ব্যবহার।
| Metric | Llama 3.2 3B | Qwen 2.5 72B |
|---|---|---|
Cost per Task Estimated USD to finish one task | $0.00 | $0.28 |
Output Tokens / Task Tokens generated per task | 3K | 32K |
Reasoning Tokens / Task Thinking tokens burned per task | 0K | 0K |
টেকনিক্যাল স্পেসিফিকেশন
অফিশিয়াল প্রোভাইডার রিলিজ স্পেক্স, API মডেল আইডি, রেট লিমিট, লং-কনটেক্সট প্রাইসিং ও এজেন্টিক সক্ষমতা
| বৈশিষ্ট্য | Llama 3.2 3B | Qwen 2.5 72B |
|---|---|---|
| অফিশিয়াল API মডেল আইডি (SDK) | meta-llama/Llama-3.2-3B | qwen-2-5-72b-instruct |
| API প্রোটোকল | OpenAI-Compatible REST / vLLM / SGLang / HuggingFace TGI | OpenAI-Compatible REST / vLLM / SGLang / HuggingFace TGI |
| রিলিজ তারিখ | 2024-09 | 2024-09 |
| নলেজ কাটঅফ | December 2023 | September 2024 |
| আর্কিটেকচার | Pruned and distilled compact transformer | Dense Autoregressive Transformer |
| প্যারামিটার স্কেল | 3B | 72B |
| এন্টারপ্রাইজ রেট লিমিট (RPM / TPM) | Unlimited (Hardware-bound on self-hosted GPU) / 10,000 RPM Cloud · Unlimited local throughput / 10M+ TPM Managed Cloud | Unlimited (Hardware-bound on self-hosted GPU) / 10,000 RPM Cloud · Unlimited local throughput / 10M+ TPM Managed Cloud |
| লং-কনটেক্সট প্রাইসিং (>128K/200K) | পূর্ণ কনটেক্সট উইন্ডোতে সম্পূর্ণ ফ্রি (শুধু জিপিইউ VRAM ব্যবহৃত হয়) | পূর্ণ 128K কনটেক্সট জুড়ে একই ফ্ল্যাট রেট ($0.35/1M) |
| প্রম্পট ক্যাশিং ও TTL | vLLM ও SGLang-এ স্বয়ংক্রিয় প্রিফিক্স KV-ক্যাশিং (সম্পূর্ণ বিনামূল্যে) | ক্যাশড ইনপুট রেট $0.07/1M টোকেন |
| কম্পিউটার ইউজ / GUI এজেন্ট | API ও CLI টুল-কলিং এজেন্ট সমর্থিত (র-পিক্সেল ডেস্কটপ ক্লিক ছাড়া) | API ও CLI টুল-কলিং এজেন্ট সমর্থিত (র-পিক্সেল ডেস্কটপ ক্লিক ছাড়া) |
| MCP ও প্যারালাল টুল কলিং | নেটিভ MCP সাপোর্ট · প্যারালাল ফাংশন কলিং · ১০০% স্ট্রিক্ট JSON স্কিমা | নেটিভ MCP সাপোর্ট · প্যারালাল ফাংশন কলিং · ১০০% স্ট্রিক্ট JSON স্কিমা |
| ওয়েব সার্চ ও কোড স্যান্ডবক্স | এক্সটার্নাল সার্চ (Tavily/Exa) ও ডকার স্যান্ডবক্সের মাধ্যমে সমর্থিত | এক্সটার্নাল সার্চ (Tavily/Exa) ও ডকার স্যান্ডবক্সের মাধ্যমে সমর্থিত |
| অফিশিয়াল ফাইন-টিউনিং (SFT/LoRA/RFT) | পূর্ণ ওয়েটস SFT, LoRA, QLoRA, DPO ও RL ফাইন-টিউনিং (Unsloth / Axolotl) | পূর্ণ ওয়েটস SFT, LoRA, QLoRA, DPO ও RL ফাইন-টিউনিং (Unsloth / Axolotl) |
| মাল্টিমোডাল টোকেন বিলিং | টেক্সট BPE (~৪ অক্ষর/টোকেন) | টেক্সট BPE (~৪ অক্ষর/টোকেন) |
| কোয়ান্টাইজেশন ও মিনিমাম VRAM | BF16 / FP16, FP8 Dynamic, INT4 AWQ / GPTQ, GGUF (Q4_K_M / Q8_0) · 2 GB VRAM (৪-বিট কোয়ান্টাইজড) · 6 GB VRAM (নেটিভ BF16) | BF16 / FP16, FP8 Dynamic, INT4 AWQ / GPTQ, GGUF (Q4_K_M / Q8_0) · 45 GB VRAM (৪-বিট কোয়ান্টাইজড) · 155 GB VRAM (নেটিভ BF16) |
| সেফটি ও ফ্রন্টিয়ার ক্লাসিফিকেশন | Open-Weights System Card + Customizable Guardrail Layer (Llama Guard / ShieldGemma) | Open-Weights System Card + Customizable Guardrail Layer (Llama Guard / ShieldGemma) |
| এন্টারপ্রাইজ কমপ্লায়েন্স (ZDR/HIPAA/SOC2) | ১০০% অন-প্রেমিসেস / প্রাইভেট VPC নিয়ন্ত্রণ · সম্পূর্ণ HIPAA, GDPR ও SOC2 কমপ্লায়েন্ট | ১০০% অন-প্রেমিসেস / প্রাইভেট VPC নিয়ন্ত্রণ · সম্পূর্ণ HIPAA, GDPR ও SOC2 কমপ্লায়েন্ট |
| ইনপুট মডালিটি | text | text |
| আউটপুট মডালিটি | text | text |
Llama 3.2 3B vs Qwen 2.5 72B: সংক্ষিপ্ত প্রশ্নোত্তর (FAQ)
Which is more intelligent, Llama 3.2 3B or Qwen 2.5 72B?
Llama 3.2 3B is more intelligent. It scores 52 compared with 44 on the composite Intelligence Index.
Which model is faster?
Llama 3.2 3B is faster, generating 240 tokens per second compared with 64 tokens per second.
Which model is cheaper to run?
Llama 3.2 3B is cheaper at $0.00 per 1M tokens blended, compared with $0.19 (7:2:1 cache:input:output ratio).
Which model has lower latency?
Llama 3.2 3B has lower latency, with a time to first token of 0.16s compared with 0.61s.
চূড়ান্ত মতামত
Llama 3.2 3B (সেলফ-হোস্টিং, ফাইন-টিউনিং এবং প্রাইভেট ক্লাউড ডিপ্লয়মেন্টের জন্য উন্মুক্ত ওপেন-ওয়েটস, RAG নলেজ পাইপলাইন এবং স্কেলেবল প্রোডাকশন API ইন্টিগ্রেশন।) এবং Qwen 2.5 72B (সেলফ-হোস্টিং, ফাইন-টিউনিং এবং প্রাইভেট ক্লাউড ডিপ্লয়মেন্টের জন্য উন্মুক্ত ওপেন-ওয়েটস, RAG নলেজ পাইপলাইন এবং স্কেলেবল প্রোডাকশন API ইন্টিগ্রেশন।) উভয়ই শক্তিশালী মডেল। সার্বিক রিজনিং ও কোডিং বেঞ্চমার্কে Llama 3.2 3B এগিয়ে, দ্রুত ইনফারেন্স গতির জন্য Llama 3.2 3B সেরা এবং কম এপিআই খরচে প্রোডাকশন ডিপ্লয়মেন্টের জন্য Llama 3.2 3B সবচেয়ে সাশ্রয়ী পছন্দ।
সাধারণ জিজ্ঞাসা (FAQ)
কোডিং ও জটিল রিজনিংয়ের জন্য Llama 3.2 3B নাকি Qwen 2.5 72B কোনটি ভালো?+
বেঞ্চমার্ক এবং রিজনিং মূল্যায়নে Llama 3.2 3B এগিয়ে রয়েছে। তবে আপনার নির্দিষ্ট প্রজেক্টের জন্য উভয় মডেলের SWE-bench ও GPQA স্কোর তুলনা করে নেওয়া উত্তম।
Llama 3.2 3B এবং Qwen 2.5 72B-এর এপিআই খরচের পার্থক্য কত?+
Llama 3.2 3B-এর ইনপুট/আউটপুট মূল্য $0.00 / $0.00 (প্রতি ১ মিলিয়ন টোকেন) এবং Qwen 2.5 72B-এর মূল্য $0.35 / $0.70। সার্বিক ওয়ার্কলোডে Llama 3.2 3B বেশি সাশ্রয়ী।
কোন মডেলটির কনটেক্সট উইন্ডো ও স্পিড বেশি?+
Llama 3.2 3B মডেলের কনটেক্সট উইন্ডো 128K টোকেন এবং Qwen 2.5 72B মডেলের কনটেক্সট উইন্ডো 128K টোকেন। ইনফারেন্স গতির দিক থেকে Llama 3.2 3B দ্রুততর আউটপুট প্রদান করে।
মডেলের বিভিন্ন পরিমাপক যেমন কনটেক্সট উইন্ডো, টোকেন প্রাইজ এবং রিজনিং স্কোর সম্পর্কে বিস্তারিত জানতে আমাদের এআই গ্লোসারি দেখুন।
Related reading
- Llama 3.2 3B বনাম Llama 3.2 1B: বেঞ্চমার্ক, এপিআই দাম ও স্পিড তুলনা (২০২৬)তুলনা
- Llama 3.2 90B Vision বনাম Llama 3.2 3B: বেঞ্চমার্ক, এপিআই দাম ও স্পিড তুলনা (২০২৬)তুলনা
- Qwen 2.5 72B বনাম Qwen 2.5 32B Instruct: বেঞ্চমার্ক, এপিআই দাম ও স্পিড তুলনা (২০২৬)তুলনা
- Qwen3-Next 80B-A3B Instruct বনাম Qwen 2.5 72B: বেঞ্চমার্ক, এপিআই দাম ও স্পিড তুলনা (২০২৬)তুলনা
- Aion-3.0 বনাম Aion-Mini: বেঞ্চমার্ক, এপিআই দাম ও স্পিড তুলনা (২০২৬)তুলনা
- Aion-3.0 বনাম Gemini 3.6 Flash: বেঞ্চমার্ক, এপিআই দাম ও স্পিড তুলনা (২০২৬)তুলনা
এআই ল্যাবগুলোর নতুন রিলিজের সাথে সাথে বেঞ্চমার্ক স্কোর, টোকেন প্রাইসিং এবং রেট লিমিট নিয়মিত পরিবর্তিত হয়। প্রোডাকশনে ব্যবহারের পূর্বে সর্বদা অফিশিয়াল প্রোভাইডার ডকুমেন্টেশন যাচাই করুন।
তথ্যসূত্র: Meta ও Alibaba অফিশিয়াল এপিআই ডকুমেন্টেশন এবং স্বাধীন বেঞ্চমার্ক ইভালুয়েশন (২০২৬)।