Цены на флагманские ИИ API упали на 68% в 2026 году: открытые MoE-модели сравнялись с проприетарными лидерами
Независимый мониторинг более 330 базовых моделей показывает, что разреженные архитектуры Mixture-of-Experts (MoE), кэширование промптов и конкуренция открытых весов сократили корпоративные затраты на инференс LLM более чем на две трети за последние 12 месяцев.
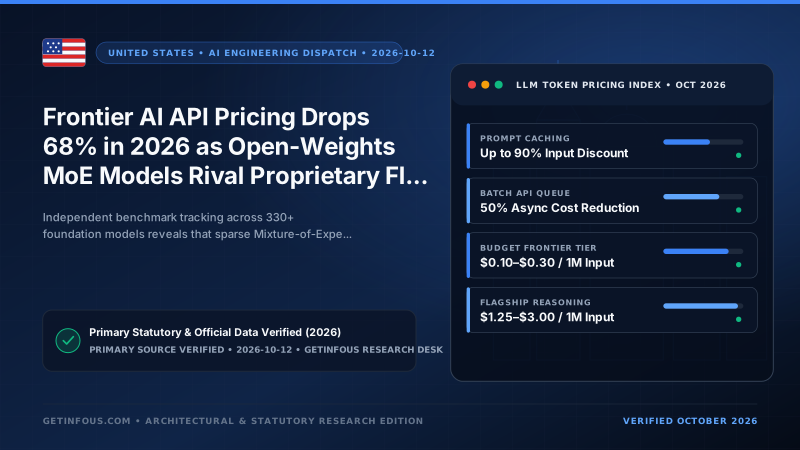
Корпоративные команды искусственного интеллекта, оценивающие API базовых моделей в октябре 2026 года, работают в совершенно иной экономической реальности по сравнению с прошлым годом. По данным аналитического отдела GetInfoUs, отслеживающего 330 флагманских и открытых моделей, медианная смешанная стоимость API (в пропорции 3:1 вход/выход) для достижения результата выше 80 баллов в MMLU-Pro и более 65% решённых задач в SWE-bench Verified снизилась примерно на 68% в годовом исчислении. Задачи, которые ранее требовали премиальных проприетарных эндпоинтов по цене от $15.00 до $75.00 за миллион выходных токенов, теперь выполняются за $0.40–$3.00 за миллион токенов благодаря разреженным архитектурам Mixture-of-Experts (MoE) и каскадной маршрутизации.
Три структурных инженерных сдвига объясняют эту дефляцию цен. Во-первых, разреженная архитектура Mixture-of-Experts стала стандартом как для открытых, так и для коммерческих провайдеров. Вместо активации сотен миллиардов плотных параметров на каждый токен современные модели — такие как DeepSeek V3.2, Qwen3.5 Max, Llama 4 Maverick и Mistral Large 2 — задействуют лишь от 32 до 45 млрд активных параметров из общего пула свыше 400 млрд, радикально снижая объём вычислений при сохранении глубины рассуждений.
Во-вторых, контекстное кэширование промптов (prompt caching) и асинхронные пакетные API (batch API) стали стандартными механизмами биллинга в OpenAI, Anthropic, Google Vertex AI и DeepSeek, обеспечивая скидки от 50% до 90% на входные токены. В-третьих, каскадные маршрутизаторы направляют 70–85% рутинных запросов классификации и суммаризации на быстрые модели дешевле $0.20 за 1 млн токенов (GPT-4.1 Nano, Gemini 2.5 Flash-Lite), оставляя тяжёлые флагманы только для сложной разработки ПО и аналитики.
Однако снижение базовых тарифов принесло новые ловушки биллинга: модели глубокого рассуждения (OpenAI o-series, GPT-5 reasoning, Claude Extended Thinking, DeepSeek R1) генерируют тысячи скрытых токенов цепочки рассуждений (CoT), тарифицируемых по полной цене выходных токенов. Поэтому оптимальная стратегия бюджетирования на 2026–2027 годы сочетает замеры стоимости на реальных задачах, мультипровайдерный роутинг и жёсткие лимиты `max_completion_tokens`.
Every dispatch published by the GetInfoUs Research Desk is cross-checked against primary government statutes, official provider documentation, and reproducible benchmark datasets before publication.
Related reading
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.