Nemotron Nano 12B v2 VL vs Nemotron Nano 9B v2
Benchmarks, API Token Pricing, Context Window & Speed Comparison
Related topics (12)
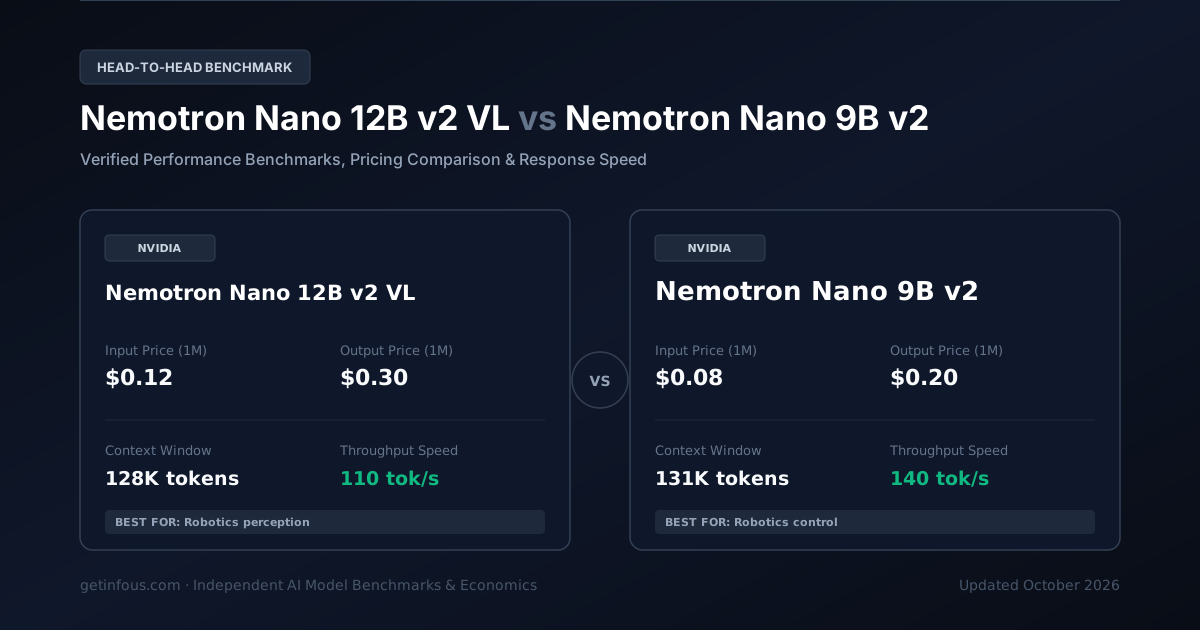
Nemotron Nano 12B v2 VL от NVIDIA и Nemotron Nano 9B v2 от NVIDIA — две ключевые модели ИИ в своём классе. Nemotron Nano 12B v2 VL предлагает контекстное окно 128K токенов по цене $0.12/$0.30 за 1 млн токенов, а Nemotron Nano 9B v2 — контекст 131.1K токенов по цене $0.08/$0.20 за 1 млн токенов. Ниже представлено сравнение бенчмарков, задержки и экономики.
Выбирайте и сравнивайте любые модели
Select any AI models from our verified benchmark database to generate live side-by-side matrices.
Nemotron Nano 12B v2 VL
Нативная мультимодальная ИИNemotron Nano 12B v2 VL от NVIDIA — специализированная ИИ-модель для нативной мультимодальной обработки текста и изображений, а также анализа документов, обеспечивающая контекстное окно 128K, скорость 110 ток/с и индекс интеллекта 43/100 (п
$0.12 / 1M
$0.30 / 1M
128K tokens
31%
Nemotron Nano 9B v2
Компактная экономичная модельNemotron Nano 9B v2 от NVIDIA — специализированная ИИ-модель для максимальной экономической эффективности на токен и быстрого продакшен-инференса, обеспечивающая контекстное окно 131K, скорость 140 ток/с и индекс интеллекта 42/100 (по цене
$0.08 / 1M
$0.20 / 1M
131.1K tokens
32.5%
Ключевые отличия кратко
- Nemotron Nano 9B v2 is 1.5x cheaper for API usage (input + output tokens combined).
- Nemotron Nano 9B v2 has a larger context window (131K vs 128K tokens).
- Nemotron Nano 9B v2 is faster at 140 tok/s vs 110 tok/s.
- Nemotron Nano 9B v2 leads on SWE-bench coding (32.5% vs 31.0%).
| Feature | Nemotron Nano 12B v2 VL | Nemotron Nano 9B v2 |
|---|---|---|
Intelligence Index Composite reasoning & knowledge score (0-100) | 43 | 42 |
Provider | NVIDIA | NVIDIA |
Input Price Cost per million input tokens | $0.12 / 1M | $0.08 / 1M |
Output Price Cost per million output tokens | $0.30 / 1M | $0.20 / 1M |
Blended Price Weighted 7:2:1 cache:input:output per 1M | $0.07 / 1M | $0.05 / 1M |
Context Window Maximum input + output tokens | 128K tokens~192 A4 pages of text | 131.1K tokens~197 A4 pages of text |
Max Output Tokens Per single request | 8K | 8K |
Throughput Speed Tokens generated per second | 110 tok/s | 140 tok/s |
SWE-bench Verified Real-world software engineering | 31% | 32.5% |
GPQA Diamond Graduate-level reasoning | 47% | 48% |
Cached Input Price Prompt caching discount per 1M tokens | $0.03 / 1M | $0.02 / 1M |
Кто лидирует в каждой категории?
At-a-glance decision frameworkРезультаты проверенных бенчмарков
Official evaluation metrics verified by independent third-party research labs.
Industry benchmark evaluating real-world GitHub issue resolution and multi-file debugging.
Challenging questions created by domain experts to test complex PhD-level reasoning.
Hardened reasoning and academic knowledge benchmark with reduced lucky-guess probability.
Crowdsourced human preference evaluation based on blind, head-to-head model battles.
Autonomous multi-step tasks executed inside a real command-line terminal environment.
American Invitational Mathematics Examination — multi-step Olympiad-level reasoning.
Accuracy when reasoning over very large inputs that fill the model context window.
Tokens emitted per second during active generation streaming.
Задержка и скорость ответа
Time to first token (TTFT) and estimated end-to-end response time for a typical 500-token response.
Интерактивный калькулятор стоимости токенов
Adjust sliders to calculate projected monthly cloud API spending with prompt caching discounts.
Nemotron Nano 12B v2 VL · Strengths & Key Advantages
- Контекстное окно 128K и генерация до 8K выходных токенов за ответ (SWE-bench Verified 31% · GPQA Diamond 47%)
- Высокая скорость генерации 110 токенов/сек при задержке до первого токена (TTFT) всего 350 мс
- Открытые веса модели (12B) для локального хостинга и дообучения через vLLM, SGLang или Ollama
Considerations & Trade-offs
- Для локального запуска в полной точности требуются GPU-серверы с достаточным объемом видеопамяти (VRAM)
- В сверхсложных научных доказательствах специализированные тяжелые модели рассуждения могут показывать большую глубину
Nemotron Nano 9B v2 · Strengths & Key Advantages
- Контекстное окно 131K и генерация до 8K выходных токенов за ответ (SWE-bench Verified 32.5% · GPQA Diamond 48%)
- Высокая скорость генерации 140 токенов/сек при задержке до первого токена (TTFT) всего 280 мс
- Открытые веса модели (9B) для локального хостинга и дообучения через vLLM, SGLang или Ollama
Considerations & Trade-offs
- Для локального запуска в полной точности требуются GPU-серверы с достаточным объемом видеопамяти (VRAM)
- В сверхсложных научных доказательствах специализированные тяжелые модели рассуждения могут показывать большую глубину
Token Use & Task Economics
Estimated cost and token consumption to complete one representative agentic task.
| Metric | Nemotron Nano 12B v2 VL | Nemotron Nano 9B v2 |
|---|---|---|
Cost per Task Estimated USD to finish one task | $0.09 | $0.06 |
Output Tokens / Task Tokens generated per task | 24K | 22K |
Reasoning Tokens / Task Thinking tokens burned per task | 8K | 8K |
Технические характеристики
Architecture, release timeline, capabilities, and modalities.
| Feature | Nemotron Nano 12B v2 VL | Nemotron Nano 9B v2 |
|---|---|---|
| Official API Model ID (SDK) | nemotron-nano-12b-v2-vl | nemotron-nano-9b-v2 |
| API Protocol | OpenAI-Compatible REST / vLLM / SGLang / HuggingFace TGI | OpenAI-Compatible REST / vLLM / SGLang / HuggingFace TGI |
| Release Date | 2025-10 | 2025-08 |
| Knowledge Cutoff | August 2025 | June 2025 |
| Architecture | Compact Vision-Language Transformer | Efficient Dense Transformer |
| Parameters | 12B | 9B |
| Enterprise Rate Limits (RPM / TPM) | Unlimited (Hardware-bound on self-hosted GPU) / 10,000 RPM Cloud · Unlimited local throughput / 10M+ TPM Managed Cloud | Unlimited (Hardware-bound on self-hosted GPU) / 10,000 RPM Cloud · Unlimited local throughput / 10M+ TPM Managed Cloud |
| Long-Context Tier (>128K/200K) | Flat rate ($0.12/1M in) across full 128K window | Flat rate ($0.08/1M in) across full 131K window |
| Prompt Cache Policy & TTL | Cached input at $0.03/1M tokens | Cached input at $0.02/1M tokens |
| Computer Use / GUI Agent | API / CLI Tool-Use & DOM Agent ready (no raw pixel desktop click loop) | API / CLI Tool-Use & DOM Agent ready (no raw pixel desktop click loop) |
| MCP & Parallel Tool Calling | Native MCP Client/Server ready · Parallel function calling · 100% Strict JSON Schema | Native MCP Client/Server ready · Parallel function calling · 100% Strict JSON Schema |
| Web Search Grounding & Sandbox | Supported via external Tavily/Exa Search & E2B/Docker Sandbox tools | Supported via external Tavily/Exa Search & E2B/Docker Sandbox tools |
| Official Fine-Tuning Support | Full Weights SFT, LoRA, QLoRA, DPO & GRPO RL (Unsloth / Axolotl / Llama-Factory) | Full Weights SFT, LoRA, QLoRA, DPO & GRPO RL (Unsloth / Axolotl / Llama-Factory) |
| Multimodal Token Billing | Text BPE (~4 chars/token) · Vision (~258–765 tokens per image tile) | Text BPE (~4 chars/token) |
| Quantization & Min GPU VRAM | BF16 / FP16, FP8 Dynamic, INT4 AWQ / GPTQ, GGUF (Q4_K_M / Q8_0) · 7 GB VRAM (4-bit Quantized) · 26 GB VRAM (Native BF16) | BF16 / FP16, FP8 Dynamic, INT4 AWQ / GPTQ, GGUF (Q4_K_M / Q8_0) · 6 GB VRAM (4-bit Quantized) · 19 GB VRAM (Native BF16) |
| Safety & Frontier Classification | Open-Weights System Card + Customizable Guardrail Layer (Llama Guard / ShieldGemma) | Open-Weights System Card + Customizable Guardrail Layer (Llama Guard / ShieldGemma) |
| Enterprise Compliance (ZDR/HIPAA/SOC2) | 100% Air-Gapped On-Premises / Private VPC · Full HIPAA, GDPR & SOC2 Control | 100% Air-Gapped On-Premises / Private VPC · Full HIPAA, GDPR & SOC2 Control |
| Input Modalities | text, vision | text |
| Output Modalities | text | text |
Nemotron Nano 12B v2 VL vs Nemotron Nano 9B v2: Быстрые ответы (FAQ)
Which is more intelligent, Nemotron Nano 12B v2 VL or Nemotron Nano 9B v2?
Nemotron Nano 12B v2 VL is more intelligent. It scores 43 compared with 42 on the composite Intelligence Index.
Which model is faster?
Nemotron Nano 9B v2 is faster, generating 140 tokens per second compared with 110 tokens per second.
Which model is cheaper to run?
Nemotron Nano 9B v2 is cheaper at $0.05 per 1M tokens blended, compared with $0.07 (7:2:1 cache:input:output ratio).
Which model has lower latency?
Nemotron Nano 9B v2 has lower latency, with a time to first token of 0.28s compared with 0.35s.
Which model has a larger context window?
Nemotron Nano 9B v2 has a larger context window, supporting 131.1K tokens compared with 128K tokens.
Вердикт
И Nemotron Nano 12B v2 VL (Оптимально для нативной мультимодальной обработки текста и изображений, а также анализа документов, корпоративных RAG-пайплайнов и масштабируемых API-сервисов.), и Nemotron Nano 9B v2 (Оптимально для максимальной экономической эффективности на токен и быстрого продакшен-инференса, корпоративных RAG-пайплайнов и масштабируемых API-сервисов.) отлично подходят для продакшена: Nemotron Nano 12B v2 VL лидирует в сложных тестах логики и кода, Nemotron Nano 9B v2 обеспечивает более высокую скорость генерации, а Nemotron Nano 9B v2 выгоднее при больших объёмах API-запросов.
Часто задаваемые вопросы (FAQ)
Что лучше для программирования и логики: Nemotron Nano 12B v2 VL или Nemotron Nano 9B v2?+
По сводному индексу интеллекта и тестам программирования лидирует Nemotron Nano 12B v2 VL. Подробные баллы SWE-bench и GPQA приведены в таблице выше.
У какой модели дешевле API — Nemotron Nano 12B v2 VL или Nemotron Nano 9B v2?+
Тариф Nemotron Nano 12B v2 VL составляет $0.12 / $0.30 за 1 млн входных/выходных токенов, а Nemotron Nano 9B v2 — $0.08 / $0.20. По смешанной стоимости выгоднее Nemotron Nano 9B v2.
У какой модели больше окно контекста и выше скорость?+
Nemotron Nano 12B v2 VL поддерживает контекст 128K токенов против 131.1K токенов у Nemotron Nano 9B v2, а по скорости генерации токенов лидирует Nemotron Nano 9B v2.
Understand key metrics like context window, token pricing, reasoning mode, and SWE-bench scores in our comprehensive AI glossary.
Related reading
- Nemotron 3 Nano 30B A3B против Nemotron Nano 12B v2 VL: Сравнение бенчмарков, цен API и скорости (2026)Сравнение
- Nemotron Nano 12B v2 VL против GPT-OSS 20B: Сравнение бенчмарков, цен API и скорости (2026)Сравнение
- Nemotron Nano 9B v2 против GPT-OSS 20B: Сравнение бенчмарков, цен API и скорости (2026)Сравнение
- Nemotron Nano 9B v2 против Nemotron Research Reasoning: Сравнение бенчмарков, цен API и скорости (2026)Сравнение
- Aion-3.0 против Aion-Mini: Сравнение бенчмарков, цен API и скорости (2026)Сравнение
- Aion-3.0 против Gemini 3.6 Flash: Сравнение бенчмарков, цен API и скорости (2026)Сравнение
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.
Официальные источники: Официальная документация API NVIDIA и NVIDIA, системные карточки и независимые бенчмарки (2026).