I Prezzi delle API IA di Frontiera Calano del 68% nel 2026 mentre i Modelli MoE Open-Weights Eguagliano i Flagship Proprietari
Il monitoraggio indipendente dei benchmark su oltre 330 modelli fondazionali rivela che le architetture sparse Mixture-of-Experts (MoE), il prompt caching e la competizione open-weights hanno ridotto i costi di inferenza LLM aziendali di oltre due terzi negli ultimi dodici mesi.
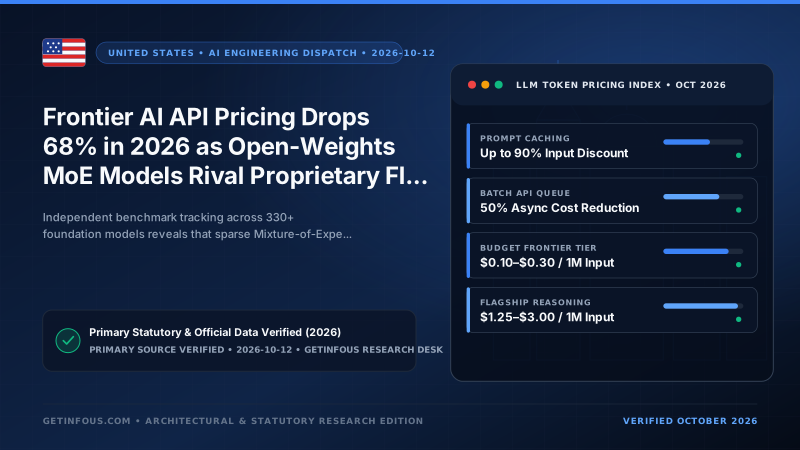
I team aziendali di intelligenza artificiale che valutano le API dei modelli fondazionali nell'ottobre 2026 si trovano di fronte a un panorama economico radicalmente diverso rispetto a soli dodici mesi fa. Nei 330 modelli di frontiera e open-weights monitorati dal GetInfoUs Research Desk, il costo mediano combinato (3:1) delle API necessario per ottenere un punteggio superiore a 80 su MMLU-Pro e un tasso di risoluzione oltre il 65% su SWE-bench Verified è sceso di circa il 68% su base annua. Ciò che in precedenza richiedeva endpoint proprietari premium da 15,00$ a 75,00$ per milione di token di output può ora essere eseguito a 0,40$–3,00$ per milione di token grazie alle architetture sparse Mixture-of-Experts (MoE) e a livelli di routing ad alta efficienza.
Tre cambiamenti ingegneristici strutturali spiegano questa rapida deflazione dei prezzi. In primo luogo, le architetture sparse Mixture-of-Experts sono diventate lo standard progettuale sia per i fornitori open-weights sia per quelli commerciali. Invece di attivare centinaia di miliardi di parametri densi per ogni singolo token generato, modelli moderni come DeepSeek V3.2, Qwen3.5 Max, Llama 4 Maverick e Mistral Large 2 attivano solo un sottoinsieme specializzato compreso tra 32 e 45 miliardi di parametri attivi su un pool totale di oltre 400 miliardi, riducendo drasticamente le operazioni in virgola mobile per token senza sacrificare la profondità di ragionamento.
In secondo luogo, il prompt caching contestuale e le API batch asincrone sono diventati meccanismi di fatturazione standard su OpenAI, Anthropic, Google Vertex AI e DeepSeek, offrendo sconti dal 50% al 90% sulle tariffe di input. In terzo luogo, le cascate di routing ibrido dei prompt consentono ai gateway di produzione di instradare il 70%–85% delle query di classificazione e riepilogo verso modelli leggeri sotto 0,20$ per milione di token (come GPT-4.1 Nano o Gemini 2.5 Flash-Lite), riservando i modelli flagship solo ai compiti complessi di ingegneria del software.
Tuttavia, i responsabili tecnici devono prestare attenzione alle nuove insidie di fatturazione introdotte dai modelli a ragionamento esteso (serie o di OpenAI, GPT-5 reasoning, Claude Extended Thinking e DeepSeek R1), che generano migliaia di token interni di pensiero (chain-of-thought) fatturati alla tariffa piena di output. Combinare benchmark empirici dei costi per attività, routing multi-provider e limiti rigorosi di `max_completion_tokens` rappresenta la strategia più efficace per i budget IA 2026–2027.
Every dispatch published by the GetInfoUs Research Desk is cross-checked against primary government statutes, official provider documentation, and reproducible benchmark datasets before publication.
Related reading
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.