Gemini Embedding 2 vs Gemini Embedding 001
Benchmarks, API Token Pricing, Context Window & Speed Comparison
Related topics (12)
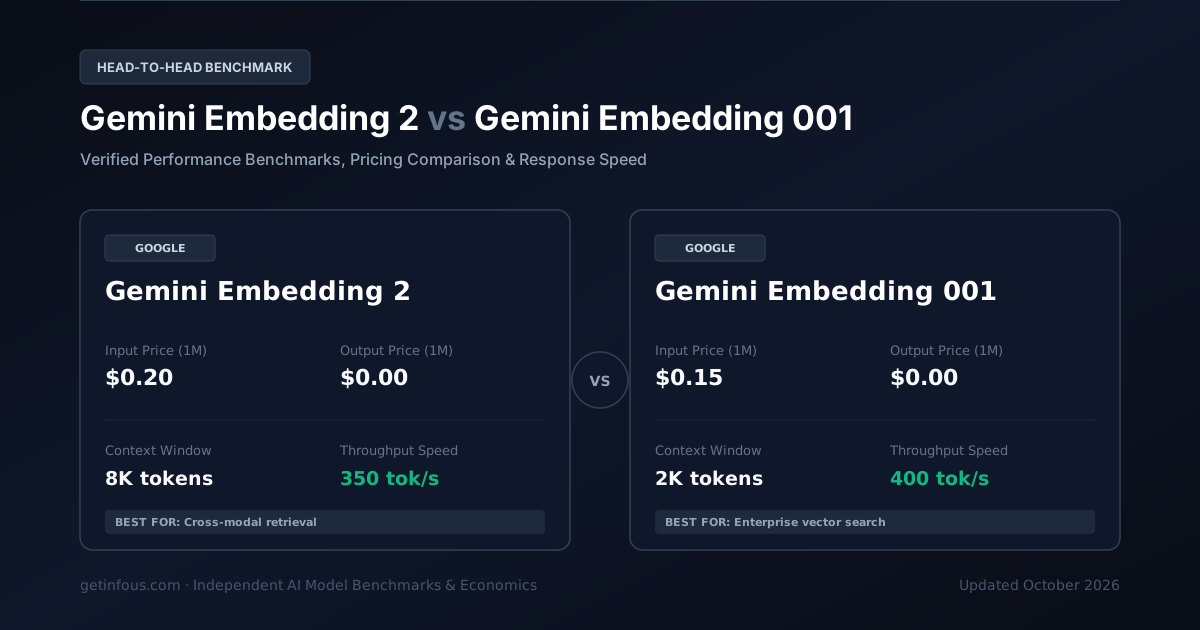
Gemini Embedding 2 di Google e Gemini Embedding 001 di Google sono due modelli di IA di riferimento. Gemini Embedding 2 offre una finestra di contesto di 8.2K token a $0.20/$0.00 per milione di token, mentre Gemini Embedding 001 mette a disposizione 2K token di contesto a $0.15/$0.00 per milione di token. Di seguito analizziamo benchmark, latenza e costi.
Cambia e Confronta Qualsiasi Modello
Select any AI models from our verified benchmark database to generate live side-by-side matrices.
Gemini Embedding 2
Embedding Vettoriali e RAGGemini Embedding 2 di Google è un modello di IA progettato per la ricerca vettoriale semantica, l’indicizzazione documentale e le pipeline RAG, con finestra di contesto da 8K, velocità di 350 token/s, indice di intelligenza di 78/100 e tari
$0.20 / 1M
$0.00 / 1M
8.2K tokens
N/A
Gemini Embedding 001
Embedding Vettoriali e RAGGemini Embedding 001 di Google è un modello di IA progettato per la ricerca vettoriale semantica, l’indicizzazione documentale e le pipeline RAG, con finestra di contesto da 2K, velocità di 400 token/s, indice di intelligenza di 70/100 e ta
$0.15 / 1M
$0.00 / 1M
2K tokens
N/A
Differenze Chiave a Colpo d’Occhio
- Gemini Embedding 001 is 1.3x cheaper for API usage (input + output tokens combined).
- Gemini Embedding 2 has a larger context window (8K vs 2K tokens).
- Gemini Embedding 001 is faster at 400 tok/s vs 350 tok/s.
| Feature | Gemini Embedding 2 | Gemini Embedding 001 |
|---|---|---|
Intelligence Index Composite reasoning & knowledge score (0-100) | 78 | 70 |
Provider | ||
Input Price Cost per million input tokens | $0.20 / 1M | $0.15 / 1M |
Output Price Cost per million output tokens | $0.00 / 1M | $0.00 / 1M |
Blended Price Weighted 7:2:1 cache:input:output per 1M | $0.04 / 1M | $0.03 / 1M |
Context Window Maximum input + output tokens | 8.2K tokens~12 A4 pages of text | 2K tokens~3 A4 pages of text |
Max Output Tokens Per single request | 4K | 4K |
Throughput Speed Tokens generated per second | 350 tok/s | 400 tok/s |
SWE-bench Verified Real-world software engineering | N/A | N/A |
Chi vince in ogni categoria?
At-a-glance decision frameworkEvaluations ongoing
Punteggi Benchmark Verificati
Official evaluation metrics verified by independent third-party research labs.
Crowdsourced human preference evaluation based on blind, head-to-head model battles.
Tokens emitted per second during active generation streaming.
Latenza e Tempo di Risposta
Time to first token (TTFT) and estimated end-to-end response time for a typical 500-token response.
Simulatore Interattivo dei Costi Token
Adjust sliders to calculate projected monthly cloud API spending with prompt caching discounts.
Gemini Embedding 2 · Strengths & Key Advantages
- Finestra di contesto da 8K con capacità massima di output fino a 4K token (Arena Elo 1340)
- Throughput elevato di 350 token/secondo con latenza al primo token (TTFT) di soli 200 ms
- Economia API competitiva ($0.2/$0 per 1M di token) con supporto per prompt caching, tool calling e output JSON strutturati
Considerations & Trade-offs
- Modello cloud proprietario chiuso; non consente il download locale dei pesi per l’esecuzione offline
- Nelle dimostrazioni scientifiche più estreme, i modelli di ragionamento pesante dedicati offrono maggiore profondità
Gemini Embedding 001 · Strengths & Key Advantages
- Finestra di contesto da 2K con capacità massima di output fino a 4K token (Arena Elo 1280)
- Throughput elevato di 400 token/secondo con latenza al primo token (TTFT) di soli 150 ms
- Economia API competitiva ($0.15/$0 per 1M di token) con supporto per prompt caching, tool calling e output JSON strutturati
Considerations & Trade-offs
- Modello cloud proprietario chiuso; non consente il download locale dei pesi per l’esecuzione offline
- Nelle dimostrazioni scientifiche più estreme, i modelli di ragionamento pesante dedicati offrono maggiore profondità
Token Use & Task Economics
Estimated cost and token consumption to complete one representative agentic task.
| Metric | Gemini Embedding 2 | Gemini Embedding 001 |
|---|---|---|
Cost per Task Estimated USD to finish one task | $0.08 | $0.05 |
Output Tokens / Task Tokens generated per task | 0K | 0K |
Reasoning Tokens / Task Thinking tokens burned per task | 0K | 0K |
Specifiche Tecniche
Architecture, release timeline, capabilities, and modalities.
| Feature | Gemini Embedding 2 | Gemini Embedding 001 |
|---|---|---|
| Official API Model ID (SDK) | models/gemini-embedding-2 | models/gemini-embedding-001 |
| API Protocol | Google Gemini API (generateContent) + OpenAI-Compatible SDK | Google Gemini API (generateContent) + OpenAI-Compatible SDK |
| Release Date | 2026-04 | 2025-05 |
| Knowledge Cutoff | February 2026 | March 2025 |
| Architecture | Unified multimodal joint-embedding transformer | Dense semantic text embedding transformer |
| Parameters | Confidential | Confidential |
| Enterprise Rate Limits (RPM / TPM) | 10,000 – 30,000 RPM (Tier 5 Enterprise) · 800,000 – 2,000,000 TPM | 10,000 – 30,000 RPM (Tier 5 Enterprise) · 800,000 – 2,000,000 TPM |
| Long-Context Tier (>128K/200K) | Flat rate ($0.2/1M in) across full 8K window | Flat rate ($0.15/1M in) across full 2K window |
| Prompt Cache Policy & TTL | Implicit + Explicit Context Caching at $0/1M with configurable TTL | Implicit + Explicit Context Caching at $0/1M with configurable TTL |
| Computer Use / GUI Agent | Supported (Screen coordinate grounding, browser & desktop GUI action loops) | Text-only completion (No GUI action loop) |
| MCP & Parallel Tool Calling | Prompt-based JSON extraction only | Prompt-based JSON extraction only |
| Web Search Grounding & Sandbox | Built-in Google Search Grounding + Managed Python Code Execution Sandbox | Built-in Google Search Grounding + Managed Python Code Execution Sandbox |
| Official Fine-Tuning Support | Vertex AI Supervised Adapter Tuning & Context Distillation | Vertex AI Supervised Adapter Tuning & Context Distillation |
| Multimodal Token Billing | Text BPE (~4 chars/token) · Vision (~258–765 tokens per image tile) · Audio (~25–32 tokens/sec) · Video (~258–300 tokens/sec) | Text BPE (~4 chars/token) |
| Quantization & Min GPU VRAM | Cloud-Hosted Proprietary (FP8 / BF16 Tensor Core Cluster) · Zero Local VRAM Required (100% Serverless Cloud API) | Cloud-Hosted Proprietary (FP8 / BF16 Tensor Core Cluster) · Zero Local VRAM Required (100% Serverless Cloud API) |
| Safety & Frontier Classification | Google DeepMind Frontier Safety Framework Verified | Google DeepMind Frontier Safety Framework Verified |
| Enterprise Compliance (ZDR/HIPAA/SOC2) | SOC2 Type II · GDPR · Zero Data Retention (ZDR) & HIPAA BAA Available on Enterprise Tier | SOC2 Type II · GDPR · Zero Data Retention (ZDR) & HIPAA BAA Available on Enterprise Tier |
| Input Modalities | text, vision, audio, video | text |
| Output Modalities | embedding | embedding |
Gemini Embedding 2 vs Gemini Embedding 001: Risposte Rapide (FAQ)
Which is more intelligent, Gemini Embedding 2 or Gemini Embedding 001?
Gemini Embedding 2 is more intelligent. It scores 78 compared with 70 on the composite Intelligence Index.
Which model is faster?
Gemini Embedding 001 is faster, generating 400 tokens per second compared with 350 tokens per second.
Which model is cheaper to run?
Gemini Embedding 001 is cheaper at $0.03 per 1M tokens blended, compared with $0.04 (7:2:1 cache:input:output ratio).
Which model has lower latency?
Gemini Embedding 001 has lower latency, with a time to first token of 0.15s compared with 0.20s.
Which model has a larger context window?
Gemini Embedding 2 has a larger context window, supporting 8.2K tokens compared with 2K tokens.
Verdetto
Sia Gemini Embedding 2 (Ideale per la ricerca vettoriale semantica, l’indicizzazione documentale e le pipeline RAG, sistemi RAG aziendali e integrazioni API scalabili.) sia Gemini Embedding 001 (Ideale per la ricerca vettoriale semantica, l’indicizzazione documentale e le pipeline RAG, sistemi RAG aziendali e integrazioni API scalabili.) eccellono in produzione: Gemini Embedding 2 guida nei benchmark di ragionamento e programmazione, Gemini Embedding 001 garantisce una generazione più rapida e Gemini Embedding 001 offre il miglior rapporto qualità-prezzo per carichi API elevati.
Domande Frequenti (FAQ)
Quale modello è migliore per coding e ragionamento, Gemini Embedding 2 o Gemini Embedding 001?+
Nell’indice di intelligenza composito e nei benchmark di programmazione prevale Gemini Embedding 2. Consulta i punteggi SWE-bench e GPQA qui sopra per tutti i dettagli.
Qual è la differenza di prezzo API tra Gemini Embedding 2 e Gemini Embedding 001?+
Gemini Embedding 2 costa $0.20 / $0.00 per milione di token di input/output, mentre Gemini Embedding 001 costa $0.15 / $0.00. Nel costo combinato, Gemini Embedding 001 risulta più economico.
Quale modello ha la finestra di contesto più ampia e la velocità maggiore?+
Gemini Embedding 2 supporta 8.2K token di contesto contro 2K token di Gemini Embedding 001, mentre Gemini Embedding 001 offre una velocità di generazione superiore.
Understand key metrics like context window, token pricing, reasoning mode, and SWE-bench scores in our comprehensive AI glossary.
Related reading
- Gemini Embedding 001 vs Llama Nemotron Embed VL 1B v2: Confronto Benchmark, Prezzi API e Velocità (2026)Confronta
- Gemini Embedding 2 vs Llama Nemotron Rerank VL 1B v2: Confronto Benchmark, Prezzi API e Velocità (2026)Confronta
- Aion-3.0 vs Aion-Mini: Confronto Benchmark, Prezzi API e Velocità (2026)Confronta
- Aion-3.0 vs Gemini 3.6 Flash: Confronto Benchmark, Prezzi API e Velocità (2026)Confronta
- Aion-Mini vs Laguna XS 2.1: Confronto Benchmark, Prezzi API e Velocità (2026)Confronta
- Aya Expanse 32B vs Llama 3.2 90B Vision: Confronto Benchmark, Prezzi API e Velocità (2026)Confronta
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.
Fonti ufficiali: Documentazione API ufficiale di Google e Google, schede di sistema e benchmark indipendenti (2026).