Les tarifs des API d’IA de pointe chutent de 68 % en 2026 grâce aux modèles MoE à poids ouverts
Le suivi de plus de 330 modèles fondationnels montre que les architectures Mixture-of-Experts (MoE), le cache de prompts et la concurrence des poids ouverts ont réduit de plus des deux tiers les coûts d’inférence en entreprise.
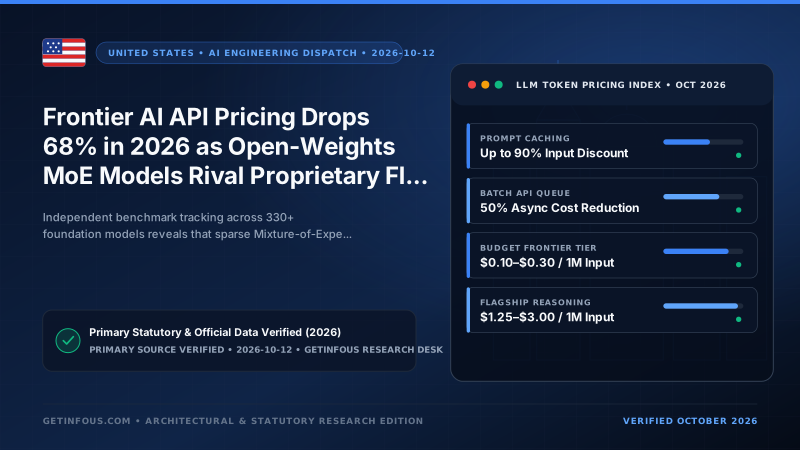
Les équipes d'intelligence artificielle en entreprise qui évaluent les API de modèles fondationnels en octobre 2026 évoluent dans un paysage économique transformé. Sur l'ensemble des 330 modèles suivis par GetInfoUs, le coût mixte 3:1 requis pour dépasser un score de 80 sur MMLU-Pro et de 65 % sur SWE-bench Verified a diminué d'environ 68 % sur douze mois. Ce qui nécessitait auparavant des points de terminaison propriétaires facturés entre 15 $ et 75 $ par million de jetons de sortie s'exécute désormais entre 0,40 $ et 3,00 $ par million de jetons grâce aux architectures Mixture-of-Experts (MoE) et aux routeurs rapides.
Trois évolutions majeures expliquent cette baisse : la généralisation des architectures MoE éparses (DeepSeek V3.2, Qwen3.5 Max, Llama 4 Maverick, Mistral Large 2), la facturation réduite de 50 à 90 % via le cache de contexte (prompt caching) et les API par lots (batch), ainsi que le routage hybride en cascade qui dirige les requêtes simples vers des modèles légers à 0,15 $/1M de jetons.
Pour optimiser leur budget d'infrastructure IA fin 2026, les entreprises combinent désormais l'analyse du coût réel par tâche, le plafonnement des jetons de raisonnement et la comparaison continue entre API sans serveur et location de GPU dédiés H100 ou A100.
Chaque dépêche publiée par l'équipe de recherche GetInfoUs est recoupée avec les textes officiels, la documentation des fournisseurs et des jeux de données reproductibles avant publication.
Related reading
Les scores de benchmarks, tarifs par token et limites évoluent rapidement. Vérifiez toujours les spécifications actuelles sur la documentation officielle du fournisseur.