Los precios de las API de IA de frontera caen un 68% en 2026 mientras los modelos MoE de pesos abiertos igualan a los propietarios
El seguimiento de más de 330 modelos fundacionales revela que las arquitecturas Mixture-of-Experts (MoE), el caché de prompts y la competencia de pesos abiertos han reducido los costos de inferencia empresarial en más de dos tercios.
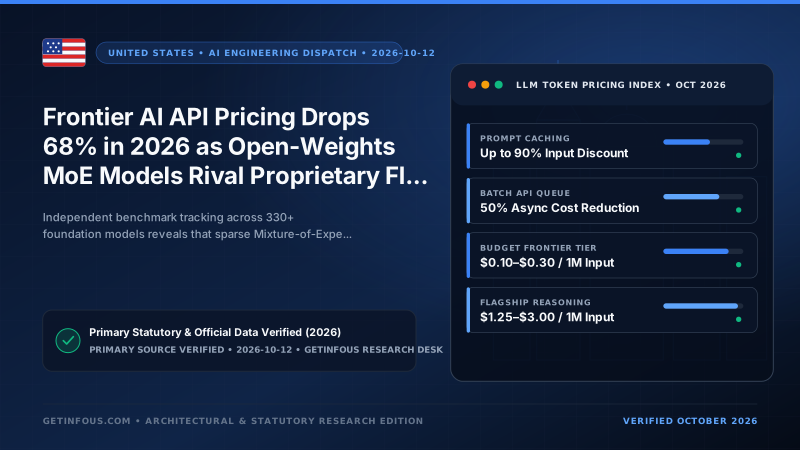
Los equipos empresariales de inteligencia artificial que evalúan las API de modelos fundacionales en octubre de 2026 se enfrentan a un panorama económico radicalmente diferente al de hace doce meses. En los 330 modelos de frontera y de pesos abiertos analizados por GetInfoUs, el costo combinado 3:1 necesario para superar los 80 puntos en MMLU-Pro y el 65 por ciento en SWE-bench Verified ha caído aproximadamente un 68 por ciento interanual. Lo que antes requería endpoints propietarios de entre $15.00 y $75.00 por millón de tokens de salida ahora puede ejecutarse entre $0.40 y $3.00 por millón de tokens mediante arquitecturas Mixture-of-Experts (MoE) y niveles de enrutamiento rápido.
Tres cambios de ingeniería explican esta deflación de precios. Primero, las arquitecturas dispersas Mixture-of-Experts se han convertido en el estándar tanto para proveedores comerciales como de pesos abiertos. En lugar de activar cientos de miles de millones de parámetros densos por cada token, modelos como DeepSeek V3.2, Qwen3.5 Max, Llama 4 Maverick y Mistral Large 2 activan únicamente un subconjunto especializado de entre 32 y 45 mil millones de parámetros activos, reduciendo drásticamente el cómputo por token sin sacrificar capacidad de razonamiento.
Segundo, el almacenamiento en caché de contexto (prompt caching) y las API por lotes (batch API) ofrecen descuentos del 50 al 90 por ciento sobre las tarifas de entrada estándar en OpenAI, Anthropic, Google Vertex AI y DeepSeek. Tercero, los enrutadores en cascada permiten enviar el 75 por ciento de las consultas rutinarias a modelos ligeros de bajo costo ($0.15/1M) y reservar los modelos insignia únicamente para tareas complejas de ingeniería de software o razonamiento científico.
Para las organizaciones que planifican su infraestructura de IA hacia finales de 2026, combinar el análisis empírico de costos por tarea con pasarelas de enrutamiento multi-proveedor y presupuestos estrictos de tokens de razonamiento permite aprovechar al máximo esta reducción histórica de costos.
Cada informe publicado por la Mesa de Investigación de GetInfoUs se verifica con leyes oficiales, documentación técnica de proveedores y conjuntos de datos reproducibles antes de su publicación.
Related reading
Las puntuaciones de benchmarks, precios por token y límites de tasa evolucionan rápidamente. Verifique siempre las especificaciones actuales en la documentación oficial del proveedor.