GLM-5-Turbo vs GLM-4.5-Flash
বেঞ্চমার্ক, এপিআই টোকেন মূল্য, কনটেক্সট উইন্ডো এবং ইনফারেন্স স্পিড তুলনা
Related topics (12)
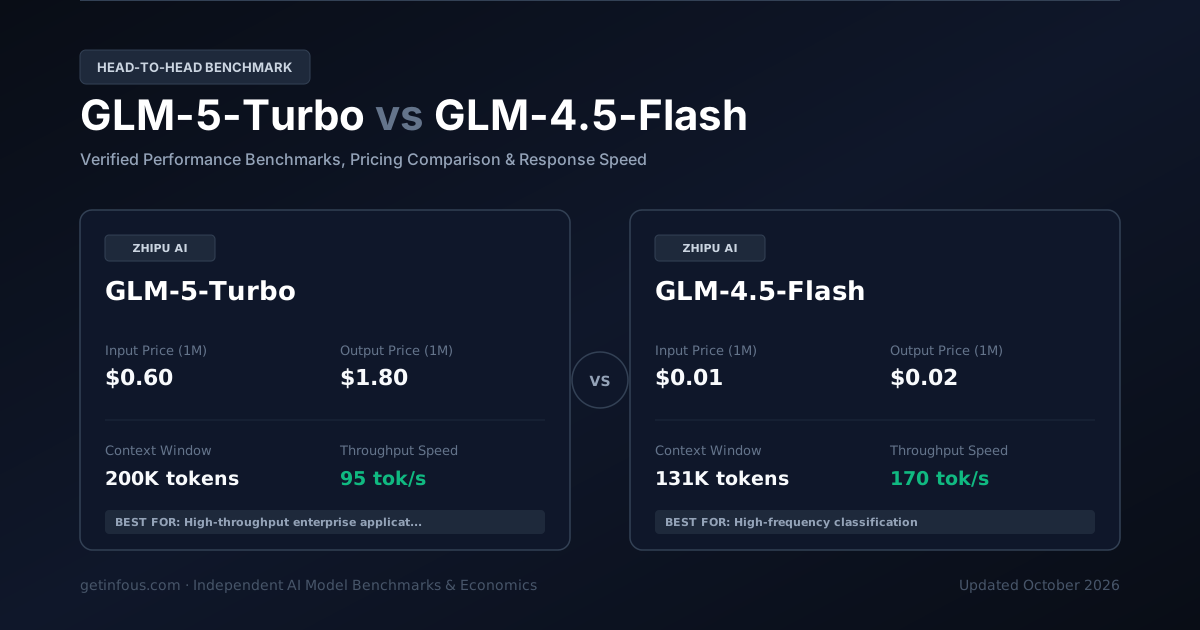
Zhipu AI-এর GLM-5-Turbo এবং Zhipu AI-এর GLM-4.5-Flash হলো দুটি শীর্ষস্থানীয় এআই মডেল। GLM-5-Turbo মডেলে রয়েছে 200K টোকেন কনটেক্সট উইন্ডো এবং এর এপিআই মূল্য $0.60/$1.80 প্রতি ১ মিলিয়ন টোকেন, যেখানে GLM-4.5-Flash মডেলে রয়েছে 131.1K টোকেন কনটেক্সট এবং মূল্য $0.01/$0.02 প্রতি ১ মিলিয়ন টোকেন। নিচে উভয় মডেলের বেঞ্চমার্ক, গতি ও খরচের বিস্তারিত তুলনা দেওয়া হলো।
যেকোনো দুটি এআই মডেল পরিবর্তন ও তুলনা করুন
আমাদের যাচাইকৃত বেঞ্চমার্ক ডাটাবেস থেকে যেকোনো এআই মডেল নির্বাচন করে তাৎক্ষণিক তুলনা দেখুন।
GLM-5-Turbo
আল্ট্রা-ফাস্ট লো-ল্যাটেন্সিZhipu AI-এর GLM-5-Turbo হলো রিয়েল-টাইম চ্যাট, হাই-ভলিউম রাউটিং ও আল্ট্রা-লো ল্যাটেন্সি অ্যাপ্লিকেশনের জন্য তৈরি এআই মডেল, যা 200K কনটেক্সট উইন্ডো, 95 টোকেন/সেকেন্ড স্পিড এবং $0.6/$1.8 প্রতি 1M টোকেন মূল্যে 86/100 ইন্টেলিজেন্স স্কোর প্রদান
$0.60 / 1M
$1.80 / 1M
200K tokens
55%
GLM-4.5-Flash
আল্ট্রা-ফাস্ট লো-ল্যাটেন্সিZhipu AI-এর GLM-4.5-Flash হলো রিয়েল-টাইম চ্যাট, হাই-ভলিউম রাউটিং ও আল্ট্রা-লো ল্যাটেন্সি অ্যাপ্লিকেশনের জন্য তৈরি এআই মডেল, যা 131K কনটেক্সট উইন্ডো, 170 টোকেন/সেকেন্ড স্পিড এবং $0.01/$0.02 প্রতি 1M টোকেন মূল্যে 72/100 ইন্টেলিজেন্স স্কোর প্
$0.01 / 1M
$0.02 / 1M
131.1K tokens
N/A
একনজরে প্রধান পার্থক্যসমূহ
- GLM-4.5-Flash is 75.7x cheaper for API usage (input + output tokens combined).
- GLM-5-Turbo has a larger context window (200K vs 131K tokens).
- GLM-4.5-Flash is faster at 170 tok/s vs 95 tok/s.
| বৈশিষ্ট্য | GLM-5-Turbo | GLM-4.5-Flash |
|---|---|---|
Intelligence Index Composite reasoning & knowledge score (0-100) | 86 | 72 |
Provider | Zhipu AI | Zhipu AI |
Input Price Cost per million input tokens | $0.60 / 1M | $0.01 / 1M |
Output Price Cost per million output tokens | $1.80 / 1M | $0.02 / 1M |
Blended Price Weighted 7:2:1 cache:input:output per 1M | $0.34 / 1M | $0.00 / 1M |
Context Window Maximum input + output tokens | 200K tokens~300 A4 pages of text | 131.1K tokens~197 A4 pages of text |
Max Output Tokens Per single request | 16K | 8K |
Throughput Speed Tokens generated per second | 95 tok/s | 170 tok/s |
SWE-bench Verified Real-world software engineering | 55% | N/A |
GPQA Diamond Graduate-level reasoning | 65% | N/A |
Cached Input Price Prompt caching discount per 1M tokens | $0.06 / 1M | $0.00 / 1M |
কোন ক্ষেত্রে কোন মডেল সেরা?
একনজরে সিদ্ধান্ত নেওয়ার ফ্রেমওয়ার্কEvaluations ongoing
যাচাইকৃত বেঞ্চমার্ক স্কোর তুলনা
স্বাধীন গবেষণা ল্যাব দ্বারা যাচাইকৃত অফিশিয়াল ইভ্যালুয়েশন মেট্রিক্স।
Industry benchmark evaluating real-world GitHub issue resolution and multi-file debugging.
Challenging questions created by domain experts to test complex PhD-level reasoning.
Hardened reasoning and academic knowledge benchmark with reduced lucky-guess probability.
Crowdsourced human preference evaluation based on blind, head-to-head model battles.
Tokens emitted per second during active generation streaming.
লেটেন্সি ও রেসপন্স টাইম
প্রথম টোকেন আসার সময় (TTFT) এবং ৫০০ টোকেনের রেসপন্স জেনারেট করতে আনুমানিক সময়।
রিয়েল-টাইম টোকেন খরচ সিমুলেটর
প্রম্পট ক্যাশিং ডিসকাউন্টসহ মাসিক ক্লাউড API খরচ হিসাব করতে স্লাইডার পরিবর্তন করুন।
GLM-5-Turbo · শক্তি ও প্রধান সুবিধাসমূহ
- 200K কনটেক্সট উইন্ডো এবং সর্বোচ্চ 16K আউটপুট টোকেন জেনারেশন সক্ষমতা (SWE-bench Verified 55% · GPQA Diamond 65%)
- 95 টোকেন/সেকেন্ড জেনারেশন স্পিড এবং মাত্র 420ms প্রথম টোকেন ল্যাটেন্সি (TTFT)
- $0.6/$1.8 প্রতি 1M টোকেন মূল্যে প্রম্পট ক্যাশিং এবং স্ট্রাকচার্ড JSON টুল-কলিং পাইপলাইন সাপোর্ট
বিবেচ্য বিষয় ও সীমাবদ্ধতা
- প্রোপ্রাইটারি ক্লাউড মডেল — লোকাল অন-প্রিমাইজ GPU-তে ওপেন-ওয়েটস হিসেবে ডাউনলোড করা যায় না
- অত্যন্ত জটিল মাল্টি-হপ গবেষণার ক্ষেত্রে ফ্ল্যাগশিপ রিজনিং মডেলের তুলনায় নির্ভুলতা কিছুটা কম হতে পারে
GLM-4.5-Flash · শক্তি ও প্রধান সুবিধাসমূহ
- 131K কনটেক্সট উইন্ডো এবং সর্বোচ্চ 8K আউটপুট টোকেন জেনারেশন সক্ষমতা (MMLU-Pro 68% · Arena Elo 1240)
- 170 টোকেন/সেকেন্ড জেনারেশন স্পিড এবং মাত্র 220ms প্রথম টোকেন ল্যাটেন্সি (TTFT)
- $0.01/$0.02 প্রতি 1M টোকেন মূল্যে প্রম্পট ক্যাশিং এবং স্ট্রাকচার্ড JSON টুল-কলিং পাইপলাইন সাপোর্ট
বিবেচ্য বিষয় ও সীমাবদ্ধতা
- প্রোপ্রাইটারি ক্লাউড মডেল — লোকাল অন-প্রিমাইজ GPU-তে ওপেন-ওয়েটস হিসেবে ডাউনলোড করা যায় না
- অত্যন্ত জটিল মাল্টি-হপ গবেষণার ক্ষেত্রে ফ্ল্যাগশিপ রিজনিং মডেলের তুলনায় নির্ভুলতা কিছুটা কম হতে পারে
টোকেন ব্যবহার ও টাস্ক ইকোনমিক্স
একটি স্ট্যান্ডার্ড এজেন্টিক টাস্ক সম্পন্ন করতে আনুমানিক খরচ এবং টোকেন ব্যবহার।
| Metric | GLM-5-Turbo | GLM-4.5-Flash |
|---|---|---|
Cost per Task Estimated USD to finish one task | $0.16 | $0.01 |
Output Tokens / Task Tokens generated per task | 22K | 10K |
Reasoning Tokens / Task Thinking tokens burned per task | 7K | 0K |
টেকনিক্যাল স্পেসিফিকেশন
অফিশিয়াল প্রোভাইডার রিলিজ স্পেক্স, API মডেল আইডি, রেট লিমিট, লং-কনটেক্সট প্রাইসিং ও এজেন্টিক সক্ষমতা
| বৈশিষ্ট্য | GLM-5-Turbo | GLM-4.5-Flash |
|---|---|---|
| অফিশিয়াল API মডেল আইডি (SDK) | glm-5-turbo | glm-4-5-flash |
| API প্রোটোকল | Zhipu AI REST API (OpenAI-Compatible) | Zhipu AI REST API (OpenAI-Compatible) |
| রিলিজ তারিখ | 2026-03 | 2025-07 |
| নলেজ কাটঅফ | January 2026 | May 2025 |
| আর্কিটেকচার | Hosted Accelerated Frontier Transformer | Ultra-High-Speed Distilled Transformer |
| প্যারামিটার স্কেল | Confidential | Confidential |
| এন্টারপ্রাইজ রেট লিমিট (RPM / TPM) | 5,000 – 15,000 RPM (Production Tier) · 800,000 – 2,000,000 TPM | 5,000 – 15,000 RPM (Production Tier) · 800,000 – 2,000,000 TPM |
| লং-কনটেক্সট প্রাইসিং (>128K/200K) | পূর্ণ 200K কনটেক্সট জুড়ে একই ফ্ল্যাট রেট ($0.6/1M) | পূর্ণ 131K কনটেক্সট জুড়ে একই ফ্ল্যাট রেট ($0.01/1M) |
| প্রম্পট ক্যাশিং ও TTL | ক্যাশড ইনপুট রেট $0.06/1M টোকেন | ক্যাশড ইনপুট রেট $0.001/1M টোকেন |
| কম্পিউটার ইউজ / GUI এজেন্ট | API ও CLI টুল-কলিং এজেন্ট সমর্থিত (র-পিক্সেল ডেস্কটপ ক্লিক ছাড়া) | API ও CLI টুল-কলিং এজেন্ট সমর্থিত (র-পিক্সেল ডেস্কটপ ক্লিক ছাড়া) |
| MCP ও প্যারালাল টুল কলিং | নেটিভ MCP সাপোর্ট · প্যারালাল ফাংশন কলিং · ১০০% স্ট্রিক্ট JSON স্কিমা | নেটিভ MCP সাপোর্ট · প্যারালাল ফাংশন কলিং · ১০০% স্ট্রিক্ট JSON স্কিমা |
| ওয়েব সার্চ ও কোড স্যান্ডবক্স | এক্সটার্নাল সার্চ (Tavily/Exa) ও ডকার স্যান্ডবক্সের মাধ্যমে সমর্থিত | এক্সটার্নাল সার্চ (Tavily/Exa) ও ডকার স্যান্ডবক্সের মাধ্যমে সমর্থিত |
| অফিশিয়াল ফাইন-টিউনিং (SFT/LoRA/RFT) | API প্রম্পট অপ্টিমাইজেশন ও RAG ইন্টিগ্রেশন | API প্রম্পট অপ্টিমাইজেশন ও RAG ইন্টিগ্রেশন |
| মাল্টিমোডাল টোকেন বিলিং | টেক্সট BPE (~৪ অক্ষর/টোকেন) | টেক্সট BPE (~৪ অক্ষর/টোকেন) |
| কোয়ান্টাইজেশন ও মিনিমাম VRAM | Cloud-Hosted Proprietary (FP8 / BF16 Tensor Core Cluster) · লোকাল জিপিইউ প্রয়োজন নেই (১০০% ক্লাউড API) | Cloud-Hosted Proprietary (FP8 / BF16 Tensor Core Cluster) · লোকাল জিপিইউ প্রয়োজন নেই (১০০% ক্লাউড API) |
| সেফটি ও ফ্রন্টিয়ার ক্লাসিফিকেশন | Zhipu AI Production Safety & Alignment Verified | Zhipu AI Production Safety & Alignment Verified |
| এন্টারপ্রাইজ কমপ্লায়েন্স (ZDR/HIPAA/SOC2) | SOC2 Type II · GDPR · এন্টারপ্রাইজ টিয়ারে Zero Data Retention (ZDR) ও HIPAA BAA সুবিধা | SOC2 Type II · GDPR · এন্টারপ্রাইজ টিয়ারে Zero Data Retention (ZDR) ও HIPAA BAA সুবিধা |
| ইনপুট মডালিটি | text | text |
| আউটপুট মডালিটি | text | text |
GLM-5-Turbo vs GLM-4.5-Flash: সংক্ষিপ্ত প্রশ্নোত্তর (FAQ)
Which is more intelligent, GLM-5-Turbo or GLM-4.5-Flash?
GLM-5-Turbo is more intelligent. It scores 86 compared with 72 on the composite Intelligence Index.
Which model is faster?
GLM-4.5-Flash is faster, generating 170 tokens per second compared with 95 tokens per second.
Which model is cheaper to run?
GLM-4.5-Flash is cheaper at $0.00 per 1M tokens blended, compared with $0.34 (7:2:1 cache:input:output ratio).
Which model has lower latency?
GLM-4.5-Flash has lower latency, with a time to first token of 0.22s compared with 0.42s.
Which model has a larger context window?
GLM-5-Turbo has a larger context window, supporting 200K tokens compared with 131.1K tokens.
চূড়ান্ত মতামত
GLM-5-Turbo (রিয়েল-টাইম চ্যাট, হাই-ভলিউম রাউটিং ও আল্ট্রা-লো ল্যাটেন্সি অ্যাপ্লিকেশনের জন্য তৈরি, RAG নলেজ পাইপলাইন এবং স্কেলেবল প্রোডাকশন API ইন্টিগ্রেশন।) এবং GLM-4.5-Flash (রিয়েল-টাইম চ্যাট, হাই-ভলিউম রাউটিং ও আল্ট্রা-লো ল্যাটেন্সি অ্যাপ্লিকেশনের জন্য তৈরি, RAG নলেজ পাইপলাইন এবং স্কেলেবল প্রোডাকশন API ইন্টিগ্রেশন।) উভয়ই শক্তিশালী মডেল। সার্বিক রিজনিং ও কোডিং বেঞ্চমার্কে GLM-5-Turbo এগিয়ে, দ্রুত ইনফারেন্স গতির জন্য GLM-4.5-Flash সেরা এবং কম এপিআই খরচে প্রোডাকশন ডিপ্লয়মেন্টের জন্য GLM-4.5-Flash সবচেয়ে সাশ্রয়ী পছন্দ।
সাধারণ জিজ্ঞাসা (FAQ)
কোডিং ও জটিল রিজনিংয়ের জন্য GLM-5-Turbo নাকি GLM-4.5-Flash কোনটি ভালো?+
বেঞ্চমার্ক এবং রিজনিং মূল্যায়নে GLM-5-Turbo এগিয়ে রয়েছে। তবে আপনার নির্দিষ্ট প্রজেক্টের জন্য উভয় মডেলের SWE-bench ও GPQA স্কোর তুলনা করে নেওয়া উত্তম।
GLM-5-Turbo এবং GLM-4.5-Flash-এর এপিআই খরচের পার্থক্য কত?+
GLM-5-Turbo-এর ইনপুট/আউটপুট মূল্য $0.60 / $1.80 (প্রতি ১ মিলিয়ন টোকেন) এবং GLM-4.5-Flash-এর মূল্য $0.01 / $0.02। সার্বিক ওয়ার্কলোডে GLM-4.5-Flash বেশি সাশ্রয়ী।
কোন মডেলটির কনটেক্সট উইন্ডো ও স্পিড বেশি?+
GLM-5-Turbo মডেলের কনটেক্সট উইন্ডো 200K টোকেন এবং GLM-4.5-Flash মডেলের কনটেক্সট উইন্ডো 131.1K টোকেন। ইনফারেন্স গতির দিক থেকে GLM-4.5-Flash দ্রুততর আউটপুট প্রদান করে।
মডেলের বিভিন্ন পরিমাপক যেমন কনটেক্সট উইন্ডো, টোকেন প্রাইজ এবং রিজনিং স্কোর সম্পর্কে বিস্তারিত জানতে আমাদের এআই গ্লোসারি দেখুন।
Related reading
- Gemini 2.5 Flash বনাম GLM-4.5-Flash: বেঞ্চমার্ক, এপিআই দাম ও স্পিড তুলনা (২০২৬)তুলনা
- GLM-5-Turbo বনাম MiniMax-M2.7-highspeed: বেঞ্চমার্ক, এপিআই দাম ও স্পিড তুলনা (২০২৬)তুলনা
- GLM-5V-Turbo বনাম GLM-5-Turbo: বেঞ্চমার্ক, এপিআই দাম ও স্পিড তুলনা (২০২৬)তুলনা
- Aion-3.0 বনাম Aion-Mini: বেঞ্চমার্ক, এপিআই দাম ও স্পিড তুলনা (২০২৬)তুলনা
- Aion-3.0 বনাম Gemini 3.6 Flash: বেঞ্চমার্ক, এপিআই দাম ও স্পিড তুলনা (২০২৬)তুলনা
- Aion-Mini বনাম Laguna XS 2.1: বেঞ্চমার্ক, এপিআই দাম ও স্পিড তুলনা (২০২৬)তুলনা
এআই ল্যাবগুলোর নতুন রিলিজের সাথে সাথে বেঞ্চমার্ক স্কোর, টোকেন প্রাইসিং এবং রেট লিমিট নিয়মিত পরিবর্তিত হয়। প্রোডাকশনে ব্যবহারের পূর্বে সর্বদা অফিশিয়াল প্রোভাইডার ডকুমেন্টেশন যাচাই করুন।
তথ্যসূত্র: Zhipu AI ও Zhipu AI অফিশিয়াল এপিআই ডকুমেন্টেশন এবং স্বাধীন বেঞ্চমার্ক ইভালুয়েশন (২০২৬)।