2026 年前沿 AI API 价格暴跌 68%:开源权重 MoE 模型全面比肩商业闭源旗舰
对 330 多个基础模型的独立基准追踪显示,稀疏混合专家(MoE)架构、提示词缓存与激烈的开源权重竞争,在过去十二个月内将企业级 LLM 推理成本削减了三分之二以上。
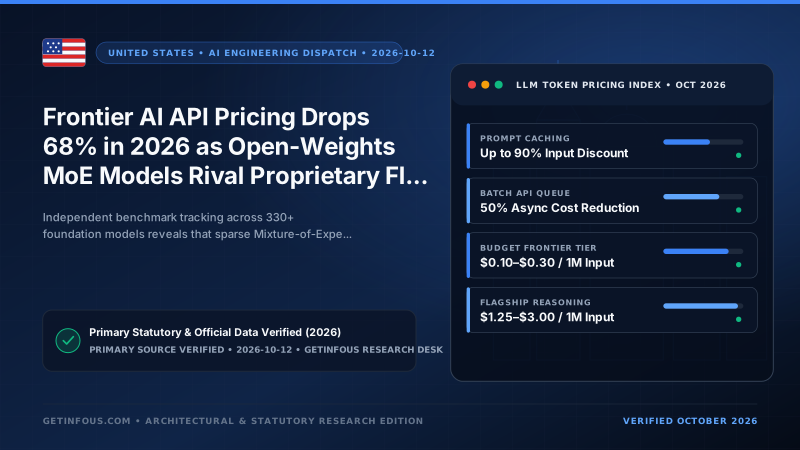
2026 年 10 月,正在评估基础模型 API 的企业人工智能团队面临着与十二个月前截然不同的经济格局。根据 GetInfoUs 研究部追踪的 330 个前沿与开源权重模型数据,在 MMLU-Pro 上取得 80 分以上且在 SWE-bench Verified 上达到 65% 以上解决率所需的 3:1 综合 API 成本中位数,同比下降了约 68%。过去需要每百万输出 Token 耗资 15 至 75 美元的顶级闭源旗舰接口,如今通过稀疏混合专家(MoE)架构与高效路由层,仅需每百万 Token 0.40 至 3.00 美元即可完成。
三大工程结构性转变解释了这一轮快速的推理价格通缩。首先,稀疏混合专家(MoE)架构已成为开源权重与商业供应商的默认设计范式。现代前沿模型(如 DeepSeek V3.2、Qwen3.5 Max、Llama 4 Maverick 与 Mistral Large 2)不再为每个生成的 Token 激活数千亿稠密参数,而是从超过 4000 亿的总参数池中仅激活 320 亿至 450 亿专用专家路由参数,在保持跨领域知识与多步推理深度的同时大幅降低了单 Token 浮点运算量。
其次,上下文提示词缓存(Prompt Caching)与异步批处理 API(Batch API)已在 OpenAI、Anthropic、Google Vertex AI 与 DeepSeek 中成为标准计费机制,提供 50% 至 90% 的输入 Token 折扣。第三,混合提示词级联路由(Cascading Routers)日趋成熟,企业网关将 70% 至 85% 的常规分类、摘要与格式化请求路由至每百万 Token 低于 0.20 美元的轻量模型(如 GPT-4.1 Nano、Gemini 2.5 Flash-Lite),仅将复杂的多文件软件工程或科学推理任务升级给旗舰模型。
然而,单价下降也带来了新的计费陷阱。深度推理模型(包括 OpenAI o 系列、GPT-5 推理层、Claude 扩展思考模式与 DeepSeek R1)在输出可见字符前会生成数千个内部思维链(CoT)Token,并按全额输出单价计费。因此,企业在规划 2026 年末至 2027 年 AI 预算时,应结合任务级实测成本基准、多供应商路由网关以及严格的 `max_completion_tokens` 上限,最大化释放推理降价红利。
Every dispatch published by the GetInfoUs Research Desk is cross-checked against primary government statutes, official provider documentation, and reproducible benchmark datasets before publication.
Related reading
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.