2026'da Öncü YZ API Fiyatları %68 Düştü: Açık Ağırlıklı MoE Modelleri Ticari Amiral Gemilerini Yakaladı
330'dan fazla temel model üzerindeki bağımsız kıyaslama takibi, seyrek Uzman Karışımı (MoE) mimarilerinin, istem önbelleklemenin ve açık ağırlıklı model rekabetinin son on iki ayda kurumsal LLM çıkarım maliyetlerini üçte ikiden fazla azalttığını ortaya koyuyor.
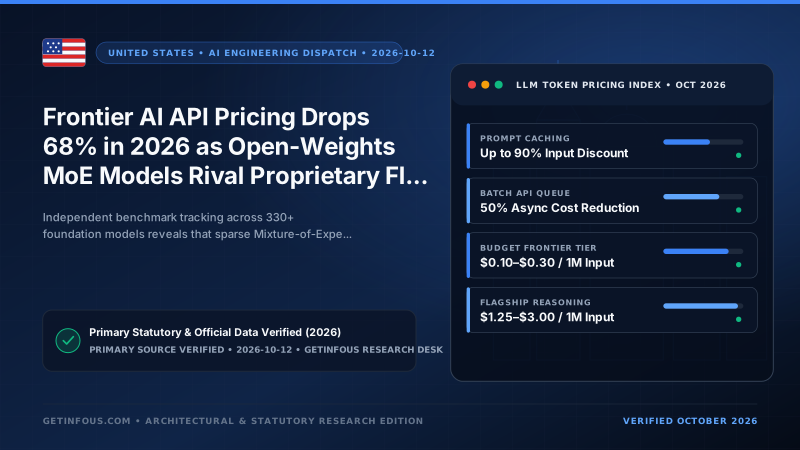
Ekim 2026'da temel model API'lerini değerlendiren kurumsal yapay zeka ekipleri, yalnızca on iki ay öncesine kıyasla tamamen farklı bir ekonomik tabloyla karşı karşıya. GetInfoUs Araştırma Masası tarafından izlenen 330 öncü ve açık ağırlıklı model genelinde, MMLU-Pro'da 80+ puan ve SWE-bench Verified'da %65+ çözüm oranına ulaşmak için gereken 3:1 karma API maliyeti medyanı yıllık bazda yaklaşık %68 düştü. Önceden milyon çıktı tokeni başına 15,00 ila 75,00 ABD doları tutarında ticari amiral gemisi uç noktaları gerektiren işlemler, artık seyrek Uzman Karışımı (Sparse MoE) mimarileri ve yüksek verimli yönlendirme katmanları sayesinde milyon token başına 0,40 ila 3,00 ABD doları maliyetle yürütülebiliyor.
Bu hızlı fiyat düşüşünü üç yapısal mühendislik değişimi açıklıyor. İlk olarak, seyrek MoE mimarileri hem açık ağırlıklı hem de ticari sağlayıcılar için varsayılan tasarım haline geldi. Üretilen her token için yüz milyarlarca yoğun parametreyi etkinleştirmek yerine DeepSeek V3.2, Qwen3.5 Max, Llama 4 Maverick ve Mistral Large 2 gibi modern modeller, 400 milyarı aşan toplam havuzdan yalnızca 32 ila 45 milyar uzman parametreyi etkinleştirerek çok adımlı akıl yürütme derinliğini korurken token başına işlem maliyetini büyük ölçüde düşürüyor.
İkinci olarak, bağlam istemi önbellekleme (prompt caching) ve eşzamansız toplu işlem (batch) API'leri OpenAI, Anthropic, Google Vertex AI ve DeepSeek genelinde standart faturalandırma mekanizmalarına dönüşerek giriş ücretlerinde %50 ila %90 indirim sağladı. Üçüncü olarak, hibrit istem yönlendirme kaskadları sayesinde rutin sınıflandırma ve özetleme sorgularının %70 ila %85'i milyon token başına 0,20 doların altındaki hafif modellere (GPT-4.1 Nano, Gemini 2.5 Flash-Lite gibi) yönlendirilirken, yalnızca karmaşık yazılım mühendisliği görevleri amiral gemisi modellere aktarılıyor.
Bununla birlikte mühendislik liderleri, görünür yanıtı üretmeden önce binlerce dahili düşünce zinciri (thinking) tokeni üreten ve bunları tam çıktı tarifesinden faturalandıran genişletilmiş akıl yürütme modellerindeki (OpenAI o-serisi, GPT-5 reasoning, Claude Extended Thinking, DeepSeek R1) yeni maliyet tuzaklarına dikkat etmelidir. Görev bazlı maliyet kıyaslamasını çoklu sağlayıcı yönlendirmesi ve sıkı `max_completion_tokens` bütçeleriyle birleştirmek, 2026–2027 YZ bütçeleri için en etkili stratejidir.
Every dispatch published by the GetInfoUs Research Desk is cross-checked against primary government statutes, official provider documentation, and reproducible benchmark datasets before publication.
Related reading
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.