Veo 3 vs Veo 2
Benchmarks, API Token Pricing, Context Window & Speed Comparison
Related topics (12)
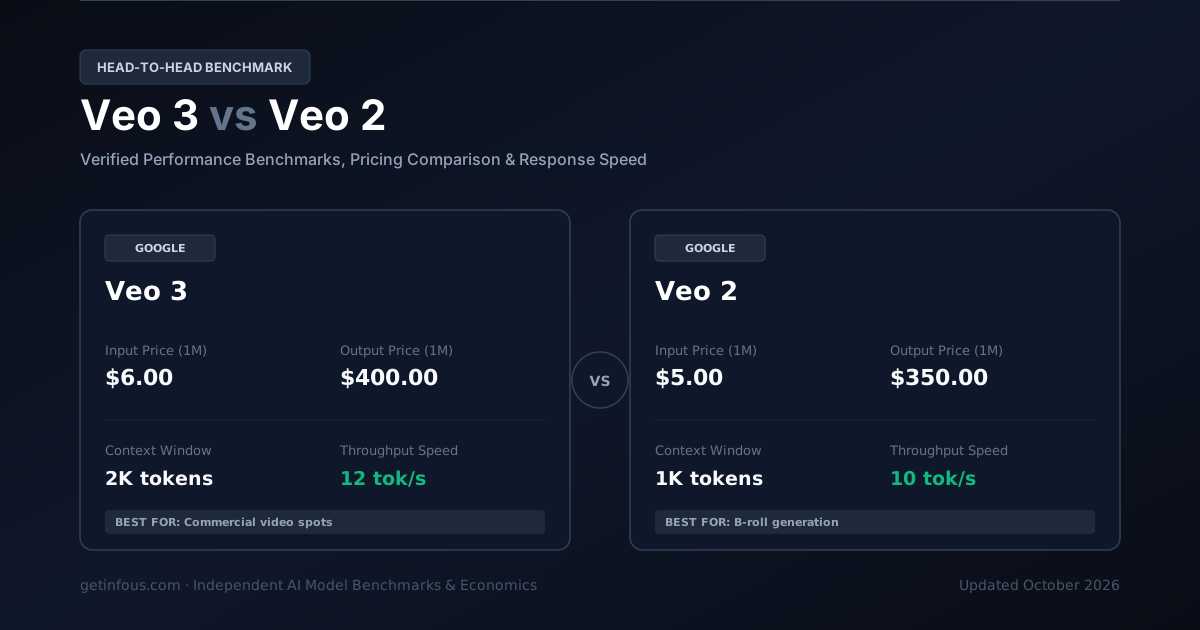
Veo 3 da Google e Veo 2 da Google são dois modelos de IA de destaque. O Veo 3 oferece uma janela de contexto de 2K tokens a $6.00/$400.00 por milhão de tokens, enquanto o Veo 2 oferece 1K tokens de contexto a $5.00/$350.00 por milhão de tokens. Veja abaixo a comparação completa de benchmarks, latência e custos.
Troque e Compare Qualquer Modelo
Select any AI models from our verified benchmark database to generate live side-by-side matrices.
Veo 3
Geração de Imagens por IAO Veo 3 da Google é um modelo de IA projetado para geração de imagens em alta resolução, design visual e tipografia precisa, oferecendo janela de contexto de 2K, velocidade de 12 tokens/s, índice de inteligência de 85/100 e tarifa de $6/$40
$6.00 / 1M
$400.00 / 1M
2K tokens
N/A
Veo 2
Geração de Imagens por IAO Veo 2 da Google é um modelo de IA projetado para geração de imagens em alta resolução, design visual e tipografia precisa, oferecendo janela de contexto de 1K, velocidade de 10 tokens/s, índice de inteligência de 75/100 e tarifa de $5/$35
$5.00 / 1M
$350.00 / 1M
1K tokens
N/A
Principais Diferenças em Resumo
- Veo 2 is 1.1x cheaper for API usage (input + output tokens combined).
- Veo 3 has a larger context window (2K vs 1K tokens).
- Veo 3 is faster at 12 tok/s vs 10 tok/s.
| Feature | Veo 3 | Veo 2 |
|---|---|---|
Intelligence Index Composite reasoning & knowledge score (0-100) | 85 | 75 |
Provider | ||
Input Price Cost per million input tokens | $6.00 / 1M | $5.00 / 1M |
Output Price Cost per million output tokens | $400.00 / 1M | $350.00 / 1M |
Blended Price Weighted 7:2:1 cache:input:output per 1M | $41.20 / 1M | $36.00 / 1M |
Context Window Maximum input + output tokens | 2K tokens~3 A4 pages of text | 1K tokens~2 A4 pages of text |
Max Output Tokens Per single request | 4K | 4K |
Throughput Speed Tokens generated per second | 12 tok/s | 10 tok/s |
SWE-bench Verified Real-world software engineering | N/A | N/A |
Quem vence em cada categoria?
At-a-glance decision frameworkEvaluations ongoing
Pontuações de Benchmarks Verificadas
Official evaluation metrics verified by independent third-party research labs.
Crowdsourced human preference evaluation based on blind, head-to-head model battles.
Tokens emitted per second during active generation streaming.
Latência e Tempo de Resposta
Time to first token (TTFT) and estimated end-to-end response time for a typical 500-token response.
Simulador Interativo de Custo de Tokens
Adjust sliders to calculate projected monthly cloud API spending with prompt caching discounts.
Veo 3 · Strengths & Key Advantages
- Janela de contexto de 2K com limite máximo de saída de 4K tokens (Arena Elo 1420)
- Taxa de transferência rápida de 12 tokens/segundo com latência inicial (TTFT) de 4500 ms
- Economia de API competitiva ($6/$400 por 1M de tokens) com suporte a cache de prompts e saídas JSON estruturadas
Considerations & Trade-offs
- Modelo proprietário em nuvem; não permite download dos pesos para execução local offline
- Para alto volume de requisições, recomenda-se ativar o cache de prompts e a Batch API para reduzir custos
Veo 2 · Strengths & Key Advantages
- Janela de contexto de 1K com limite máximo de saída de 4K tokens (Arena Elo 1340)
- Taxa de transferência rápida de 10 tokens/segundo com latência inicial (TTFT) de 5000 ms
- Economia de API competitiva ($5/$350 por 1M de tokens) com suporte a cache de prompts e saídas JSON estruturadas
Considerations & Trade-offs
- Modelo proprietário em nuvem; não permite download dos pesos para execução local offline
- Para alto volume de requisições, recomenda-se ativar o cache de prompts e a Batch API para reduzir custos
Token Use & Task Economics
Estimated cost and token consumption to complete one representative agentic task.
| Metric | Veo 3 | Veo 2 |
|---|---|---|
Cost per Task Estimated USD to finish one task | $2.50 | $1.75 |
Output Tokens / Task Tokens generated per task | 0K | 0K |
Reasoning Tokens / Task Thinking tokens burned per task | 0K | 0K |
Especificações Técnicas
Architecture, release timeline, capabilities, and modalities.
| Feature | Veo 3 | Veo 2 |
|---|---|---|
| Official API Model ID (SDK) | models/veo-3 | models/veo-2 |
| API Protocol | Google Gemini API (generateContent) + OpenAI-Compatible SDK | Google Gemini API (generateContent) + OpenAI-Compatible SDK |
| Release Date | 2025-05 | 2024-12 |
| Knowledge Cutoff | February 2025 | October 2024 |
| Architecture | Joint multimodal audio-video diffusion transformer | High-definition video diffusion transformer with camera control |
| Parameters | Confidential | Confidential |
| Enterprise Rate Limits (RPM / TPM) | 10,000 – 30,000 RPM (Tier 5 Enterprise) · 800,000 – 2,000,000 TPM | 10,000 – 30,000 RPM (Tier 5 Enterprise) · 800,000 – 2,000,000 TPM |
| Long-Context Tier (>128K/200K) | Flat rate ($6/1M in) across full 2K window | Flat rate ($5/1M in) across full 1K window |
| Prompt Cache Policy & TTL | Implicit + Explicit Context Caching at $0/1M with configurable TTL | Implicit + Explicit Context Caching at $0/1M with configurable TTL |
| Computer Use / GUI Agent | Supported (Screen coordinate grounding, browser & desktop GUI action loops) | Supported (Screen coordinate grounding, browser & desktop GUI action loops) |
| MCP & Parallel Tool Calling | Prompt-based JSON extraction only | Prompt-based JSON extraction only |
| Web Search Grounding & Sandbox | Built-in Google Search Grounding + Managed Python Code Execution Sandbox | Built-in Google Search Grounding + Managed Python Code Execution Sandbox |
| Official Fine-Tuning Support | Vertex AI Supervised Adapter Tuning & Context Distillation | Vertex AI Supervised Adapter Tuning & Context Distillation |
| Multimodal Token Billing | Text BPE (~4 chars/token) · Vision (~258–765 tokens per image tile) | Text BPE (~4 chars/token) · Vision (~258–765 tokens per image tile) |
| Quantization & Min GPU VRAM | Cloud-Hosted Proprietary (FP8 / BF16 Tensor Core Cluster) · Zero Local VRAM Required (100% Serverless Cloud API) | Cloud-Hosted Proprietary (FP8 / BF16 Tensor Core Cluster) · Zero Local VRAM Required (100% Serverless Cloud API) |
| Safety & Frontier Classification | Google DeepMind Frontier Safety Framework Verified | Google DeepMind Frontier Safety Framework Verified |
| Enterprise Compliance (ZDR/HIPAA/SOC2) | SOC2 Type II · GDPR · Zero Data Retention (ZDR) & HIPAA BAA Available on Enterprise Tier | SOC2 Type II · GDPR · Zero Data Retention (ZDR) & HIPAA BAA Available on Enterprise Tier |
| Input Modalities | text, vision | text, vision |
| Output Modalities | video | video |
Veo 3 vs Veo 2: Respostas Rápidas (FAQ)
Which is more intelligent, Veo 3 or Veo 2?
Veo 3 is more intelligent. It scores 85 compared with 75 on the composite Intelligence Index.
Which model is faster?
Veo 3 is faster, generating 12 tokens per second compared with 10 tokens per second.
Which model is cheaper to run?
Veo 2 is cheaper at $36.00 per 1M tokens blended, compared with $41.20 (7:2:1 cache:input:output ratio).
Which model has lower latency?
Veo 3 has lower latency, with a time to first token of 4.50s compared with 5.00s.
Which model has a larger context window?
Veo 3 has a larger context window, supporting 2K tokens compared with 1K tokens.
Veredito
Tanto Veo 3 (Indicado para geração de imagens em alta resolução, design visual e tipografia precisa, arquiteturas RAG corporativas e integração escalável via API.) quanto Veo 2 (Indicado para geração de imagens em alta resolução, design visual e tipografia precisa, arquiteturas RAG corporativas e integração escalável via API.) entregam excelente desempenho: Veo 3 lidera em inteligência geral e programação, Veo 3 oferece geração mais rápida e Veo 2 apresenta o melhor custo-benefício em produção.
Perguntas Frequentes (FAQ)
Qual é melhor para programação e raciocínio, Veo 3 ou Veo 2?+
Nas avaliações de inteligência e código, Veo 3 leva vantagem. Confira os gráficos SWE-bench e GPQA acima para detalhes.
Qual modelo tem a API mais barata, Veo 3 ou Veo 2?+
O Veo 3 custa $6.00 / $400.00 por 1M de tokens (entrada/saída) e o Veo 2 custa $5.00 / $350.00. No custo combinado, Veo 2 é mais econômico.
Qual modelo possui maior janela de contexto e velocidade?+
O Veo 3 suporta 2K tokens de contexto contra 1K tokens do Veo 2, enquanto Veo 3 entrega maior velocidade de geração.
Understand key metrics like context window, token pricing, reasoning mode, and SWE-bench scores in our comprehensive AI glossary.
Related reading
- Veo 2 vs. Grok Imagine Video 1.5: Comparação de Benchmarks, Preços API e Velocidade (2026)Comparar
- Veo 3.1 vs. Veo 3: Comparação de Benchmarks, Preços API e Velocidade (2026)Comparar
- Veo 3 vs. Grok Imagine Video 1.5: Comparação de Benchmarks, Preços API e Velocidade (2026)Comparar
- Aion-3.0 vs. Aion-Mini: Comparação de Benchmarks, Preços API e Velocidade (2026)Comparar
- Aion-3.0 vs. Gemini 3.6 Flash: Comparação de Benchmarks, Preços API e Velocidade (2026)Comparar
- Aion-Mini vs. Laguna XS 2.1: Comparação de Benchmarks, Preços API e Velocidade (2026)Comparar
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.
Fontes oficiais: Documentação oficial de API da Google e Google e benchmarks independentes (2026).