2026년 프런티어 AI API 가격 68% 급락: 상용 플래그십과 대등해진 오픈웨이트 MoE 모델
330개 이상의 파운데이션 모델에 대한 독립적인 벤치마크 추적 결과, 희소 전문가 혼합(MoE) 아키텍처, 프롬프트 캐싱 및 치열한 오픈웨이트 경쟁으로 인해 지난 12개월 동안 기업용 LLM 추론 비용이 3분의 2 이상 절감된 것으로 나타났습니다.
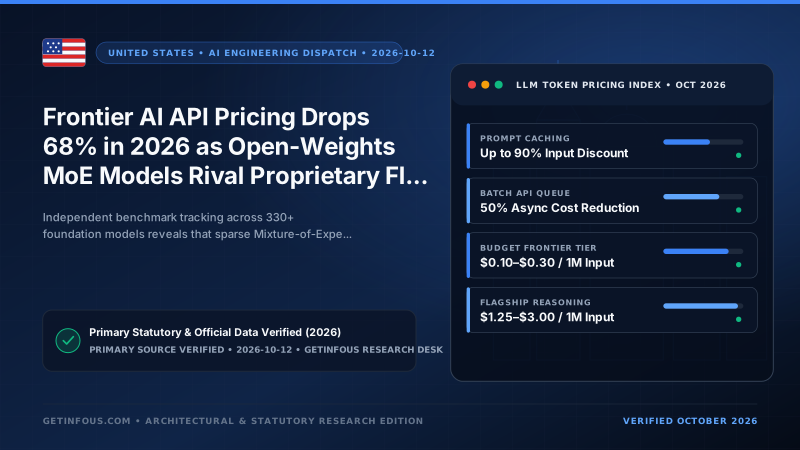
2026년 10월 파운데이션 모델 API를 평가하는 기업 인공지능 팀들은 불과 12개월 전과는 완전히 달라진 경제적 환경에 직면해 있습니다. GetInfoUs 리서치 데스크가 추적하는 330개의 프런티어 및 오픈웨이트 모델 전반에서 MMLU-Pro 80점 이상 및 SWE-bench Verified 해결률 65% 이상을 달성하는 데 필요한 3:1 혼합 API 비용 중앙값은 전년 대비 약 68% 하락했습니다. 과거 백만 출력 토큰당 $15.00~$75.00에 달하던 고가의 상용 플래그십 엔드포인트가 필요했던 작업들을 이제는 희소 전문가 혼합(Sparse MoE) 아키텍처와 고효율 라우팅 계층을 통해 백만 토큰당 $0.40~$3.00에 수행할 수 있습니다.
세 가지 구조적 엔지니어링 변화가 이러한 급격한 가격 하락을 이끌었습니다. 첫째, 희소 MoE 아키텍처가 오픈웨이트와 상용 제공업체 모두의 기본 설계 표준으로 자리 잡았습니다. 생성되는 모든 토큰마다 수천억 개의 밀집(Dense) 파라미터를 활성화하는 대신 DeepSeek V3.2, Qwen3.5 Max, Llama 4 Maverick, Mistral Large 2와 같은 최신 모델은 4,000억 개 이상의 전체 파라미터 풀에서 320억~450억 개의 특화된 전문가 경로만 활성화하여 다단계 추론 성능을 유지하면서도 토큰당 연산량을 대폭 줄였습니다.
둘째, 컨텍스트 프롬프트 캐싱(Prompt Caching)과 비동기 배치 API가 OpenAI, Anthropic, Google Vertex AI, DeepSeek 전반에서 표준 과금 체계로 정착되어 표준 입력 요금 대비 50%~90% 할인을 제공합니다. 셋째, 하이브리드 프롬프트 라우팅 캐스케이드가 성숙해지면서 프로덕션 게이트웨이가 일상적인 분류·요약·포맷팅 쿼리의 70%~85%를 백만 토큰당 $0.20 미만의 경량 모델(GPT-4.1 Nano, Gemini 2.5 Flash-Lite 등)로 라우팅하고, 복잡한 다중 파일 소프트웨어 엔지니어링 작업만 플래그십 모델로 전달합니다.
다만 토큰당 표시 가격은 낮아졌지만 확장 추론 모델(OpenAI o-시리즈, GPT-5 추론, Claude 확장 사고 모드, DeepSeek R1)이 최종 답변 출력 전에 수천~수만 개의 내부 사고(Chain-of-Thought) 토큰을 생성하고 이를 전체 출력 요금으로 과금한다는 점에 유의해야 합니다. 따라서 2026년 말~2027년 AI 인프라 예산 수립 시에는 작업 단위 실측 비용 벤치마킹, 멀티 프로바이더 라우팅, 엄격한 `max_completion_tokens` 한도 설정을 결합하는 것이 가장 효과적입니다.
Every dispatch published by the GetInfoUs Research Desk is cross-checked against primary government statutes, official provider documentation, and reproducible benchmark datasets before publication.
Related reading
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.