Frontier-KI-API-Preise fallen 2026 um 68 %: Open-Weights-MoE-Modelle ziehen mit proprietären Flaggschiffen gleich
Unabhängiges Benchmark-Tracking über mehr als 330 Basismodelle zeigt, dass Sparse-Mixture-of-Experts-Architekturen (MoE), Prompt-Caching und intensiver Open-Weights-Wettbewerb die LLM-Inferenzkosten für Unternehmen in den letzten zwölf Monaten um mehr als zwei Drittel gesenkt haben.
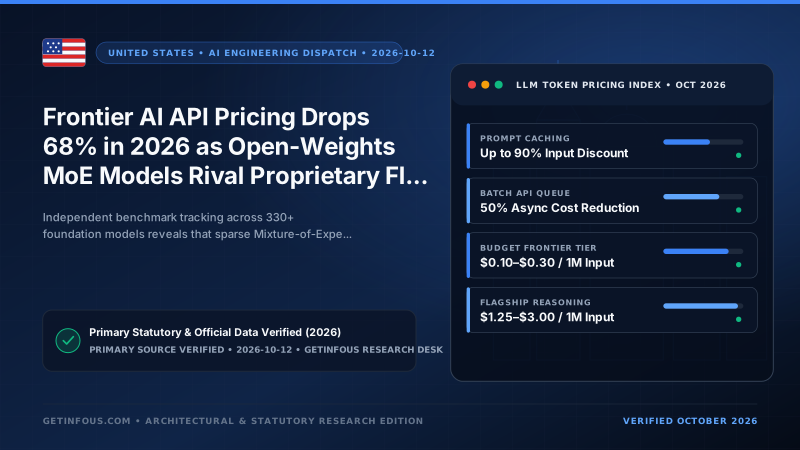
KI-Engineering-Teams in Unternehmen, die im Oktober 2026 Basismodell-APIs evaluieren, stehen vor einer völlig anderen wirtschaftlichen Realität als noch vor zwölf Monaten. Über die 330 vom GetInfoUs Research Desk analysierten Frontier- und Open-Weights-Modelle hinweg sind die mittleren kombinierten 3:1-API-Kosten, die für einen Score von über 80 auf MMLU-Pro und eine Lösungsrate von über 65 Prozent auf SWE-bench Verified erforderlich sind, im Jahresvergleich um rund 68 Prozent gesunken. Was zuvor teure proprietäre Flaggschiff-Endpunkte für 15,00 bis 75,00 US-Dollar pro Million Output-Tokens erforderte, lässt sich heute dank Sparse-Mixture-of-Experts-Architekturen (MoE) und effizientem Routing für 0,40 bis 3,00 US-Dollar pro Million Tokens ausführen.
Drei strukturelle Engineering-Entwicklungen erklären diese rasante Preisdeflation. Erstens sind Sparse-MoE-Architekturen sowohl bei Open-Weights- als auch bei kommerziellen Anbietern zum Standard geworden. Statt für jedes generierte Token Hunderte Milliarden dichter Parameter zu aktivieren, nutzen moderne Modelle wie DeepSeek V3.2, Qwen3.5 Max, Llama 4 Maverick und Mistral Large 2 nur 32 bis 45 Milliarden aktive Experten-Parameter aus einem Gesamtpool von über 400 Milliarden Parametern. Das senkt den Rechenaufwand pro Token drastisch, ohne die Tiefe beim mehrstufigen Reasoning zu beeinträchtigen.
Zweitens sind Kontext-Prompt-Caching und asynchrone Batch-APIs bei OpenAI, Anthropic, Google Vertex AI und DeepSeek zu Standard-Abrechnungsmechanismen gereift, die Rabatte von 50 bis 90 Prozent auf Input-Tokens ermöglichen. Drittens leiten hybride Prompt-Routing-Kaskaden 70 bis 85 Prozent aller Routineanfragen (Klassifizierung, Zusammenfassung, Formatierung) an schnelle Modelle unter 0,20 US-Dollar pro Million Tokens (wie GPT-4.1 Nano oder Gemini 2.5 Flash-Lite) weiter, während nur komplexe Software-Engineering-Aufgaben an die Flaggschiff-Modelle eskaliert werden.
Gleichzeitig müssen technische Leiter neue Kostenfallen bei Extended-Reasoning-Modellen (OpenAI o-Serie, GPT-5 Reasoning, Claude Extended Thinking, DeepSeek R1) beachten: Unsichtbare interne Denk-Tokens (Chain-of-Thought) werden zum vollen Output-Tarif abgerechnet und können 8.000 bis 24.000 Tokens pro Anfrage verbrauchen. Die Kombination aus aufgabenbasiertem Kosten-Benchmarking, Multi-Provider-Gateways und strikten `max_completion_tokens`-Budgets ist daher die beste Strategie für die KI-Budgets 2026 und 2027.
Every dispatch published by the GetInfoUs Research Desk is cross-checked against primary government statutes, official provider documentation, and reproducible benchmark datasets before publication.
Related reading
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.