Preços de APIs de IA de Fronteira Caem 68% em 2026 enquanto Modelos MoE de Pesos Abertos Igualam Flagships Proprietários
O acompanhamento independente de mais de 330 modelos fundacionais revela que arquiteturas esparsas Mixture-of-Experts (MoE), cache de prompts e a competição de pesos abertos reduziram os custos corporativos de inferência de LLMs em mais de dois terços nos últimos doze meses.
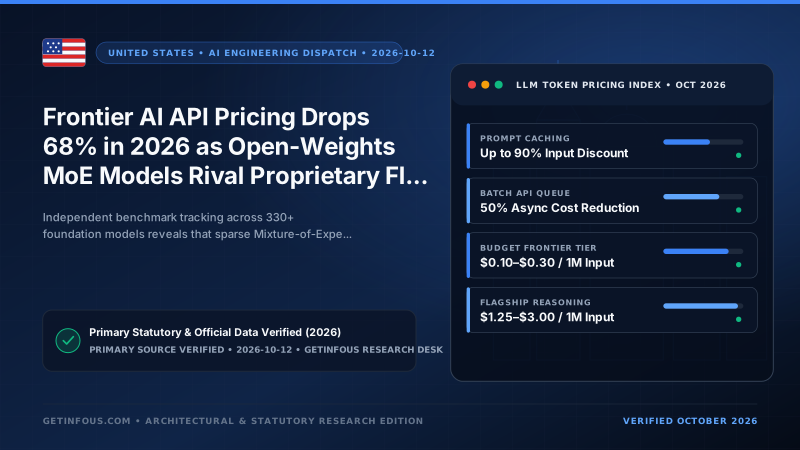
As equipes corporativas de inteligência artificial que avaliam APIs de modelos fundacionais em outubro de 2026 enfrentam um cenário econômico radicalmente diferente daquele de apenas doze meses atrás. Entre os 330 modelos de fronteira e de pesos abertos monitorados pelo GetInfoUs Research Desk, o custo médio combinado (3:1) necessário para atingir mais de 80 pontos no MMLU-Pro e mais de 65% de resolução no SWE-bench Verified caiu aproximadamente 68% ano contra ano. O que antes exigia endpoints proprietários premium custando de US$ 15,00 a US$ 75,00 por milhão de tokens de saída agora pode ser executado por US$ 0,40 a US$ 3,00 por milhão de tokens por meio de arquiteturas esparsas Mixture-of-Experts (MoE) e camadas de roteamento de alta eficiência.
Três mudanças estruturais de engenharia explicam essa rápida deflação de preços. Primeiro, as arquiteturas esparsas Mixture-of-Experts tornaram-se o padrão de projeto tanto para provedores comerciais quanto de pesos abertos. Em vez de ativar centenas de bilhões de parâmetros densos para cada token gerado, modelos modernos como DeepSeek V3.2, Qwen3.5 Max, Llama 4 Maverick e Mistral Large 2 ativam apenas um subconjunto especializado entre 32 bilhões e 45 bilhões de parâmetros ativos de um pool total superior a 400 bilhões, reduzindo drasticamente as operações de ponto flutuante por token sem perder profundidade de raciocínio.
Segundo, o cache de contexto de prompts (prompt caching) e as APIs em lote assíncronas (batch APIs) tornaram-se mecanismos padrão de faturamento na OpenAI, Anthropic, Google Vertex AI e DeepSeek, oferecendo descontos de 50% a 90% nas taxas de entrada. Terceiro, cascatas híbridas de roteamento de prompts permitem direcionar de 70% a 85% das consultas rotineiras de classificação e resumo para modelos leves abaixo de US$ 0,20 por milhão de tokens (como GPT-4.1 Nano e Gemini 2.5 Flash-Lite), reservando os flagships pesados apenas para engenharia de software multiarquivo ou dedução científica.
Contudo, líderes de engenharia devem auditar com atenção as novas armadilhas de faturamento dos modelos de raciocínio estendido (como a série o da OpenAI, GPT-5 reasoning, Claude Extended Thinking e DeepSeek R1), que geram milhares de tokens internos de cadeia de pensamento cobrados na tarifa integral de saída. Combinar benchmarking empírico por tarefa, gateways multi-provedor e limites estritos de `max_completion_tokens` é a estratégia mais eficaz para os orçamentos de IA de 2026 e 2027.
Every dispatch published by the GetInfoUs Research Desk is cross-checked against primary government statutes, official provider documentation, and reproducible benchmark datasets before publication.
Related reading
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.