2026年にフロンティアAI API価格が68%下落:オープンウェイトMoEモデルが商用フラッグシップに匹敵
330以上の基盤モデルの独自ベンチマーク追跡により、スパースMixture-of-Experts(MoE)アーキテクチャ、プロンプトキャッシュ、およびオープンウェイトモデルの競争激化によって、過去12ヶ月で企業のLLM推論コストが3分の2以上削減されたことが判明しました。
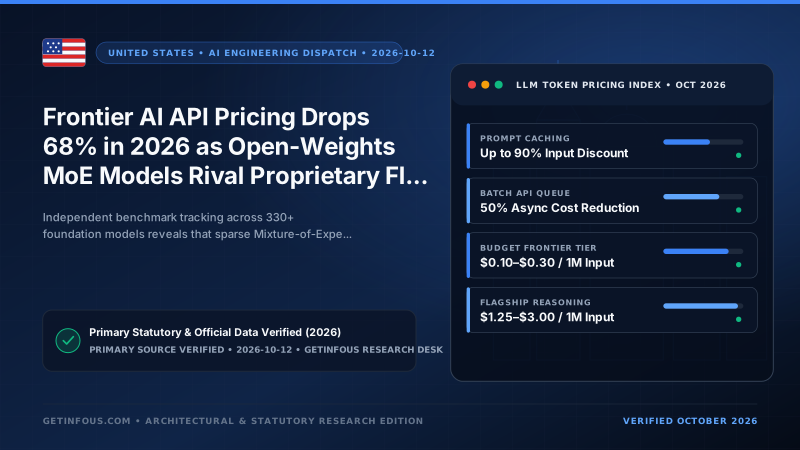
2026年10月現在、基盤モデルAPIを評価する企業のAIエンジニアリングチームは、わずか12ヶ月前とは劇的に異なる経済環境に直面しています。GetInfoUsリサーチデスクが追跡している330のフロンティアおよびオープンウェイトモデル全体で、MMLU-Proで80点以上、SWE-bench Verifiedで65%以上の解決率を達成するために必要な3:1ブレンドAPIコストの中央値は、前年比で約68%低下しました。以前は100万出力トークンあたり15〜75ドルの高価な商用フラッグシップAPIが必要だった処理が、現在ではスパースMixture-of-Experts(MoE)アーキテクチャと高効率ルーティングにより、100万トークンあたり0.40〜3.00ドルで実行可能です。
この急速な価格デフレの背景には、3つの構造的なエンジニアリングの変化があります。第一に、スパースMoEアーキテクチャが商用・オープンウェイト双方の標準設計となりました。生成トークンごとに数千億の密(Dense)パラメータを動かすのではなく、DeepSeek V3.2、Qwen3.5 Max、Llama 4 Maverick、Mistral Large 2などの最新モデルは、4,000億超の総パラメータから320億〜450億の専門エキスパート経路のみを活性化させ、推論の深さを維持しつつ演算量を大幅に削減しています。
第二に、プロンプトキャッシュ(Prompt Caching)と非同期バッチAPIがOpenAI、Anthropic、Google Vertex AI、DeepSeekで標準機能となり、入力トークン料金が50〜90%割引されるようになりました。第三に、ハイブリッドなプロンプトルーティングが定着し、定型的な分類や要約クエリの70〜85%を100万トークン0.20ドル未満の軽量モデル(GPT-4.1 NanoやGemini 2.5 Flash-Liteなど)へ振り分け、複雑なマルチファイル開発や科学的推論のみをフラッグシップモデルへ送る構成が主流となっています。
一方で、拡張推論モデル(OpenAI oシリーズ、GPT-5推論、Claude拡張思考モード、DeepSeek R1など)では、画面に表示される回答の前に数千〜数万の内部思考トークン(Thinking Tokens)が生成され、出力トークン単価で課金される点に注意が必要です。2026年末〜2027年のAIインフラ予算策定では、タスク別の実測コスト評価、マルチプロバイダルーティング、そして厳格な `max_completion_tokens` 上限設定を組み合わせることが最も効果的です。
Every dispatch published by the GetInfoUs Research Desk is cross-checked against primary government statutes, official provider documentation, and reproducible benchmark datasets before publication.
Related reading
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.