Harga API AI Frontier Turun 68% pada 2026 seiring Model MoE Open-Weights Menyaingi Flagship Proprietari
Pelacakan benchmark independen terhadap 330+ model fondasi mengungkapkan bahwa arsitektur Mixture-of-Experts (MoE) renggang, caching prompt, dan kompetisi open-weights yang agresif telah memangkas biaya inferensi LLM perusahaan lebih dari dua pertiga selama dua belas bulan terakhir.
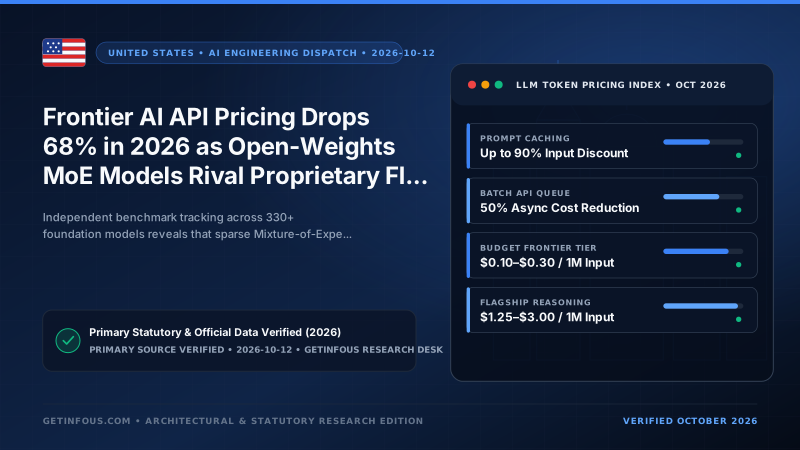
Tim kecerdasan buatan perusahaan yang mengevaluasi API model fondasi pada Oktober 2026 menghadapi lanskap ekonomi yang sangat berbeda dibandingkan dua belas bulan lalu. Di seluruh 330 model frontier dan open-weights yang dilacak oleh GetInfoUs Research Desk, median biaya API gabungan (3:1) yang diperlukan untuk mencapai skor 80+ pada MMLU-Pro dan tingkat penyelesaian 65%+ pada SWE-bench Verified telah turun sekitar 68 persen dari tahun ke tahun. Beban kerja yang sebelumnya membutuhkan endpoint flagship proprietari seharga $15,00 hingga $75,00 per juta token output kini dapat dijalankan seharga $0,40 hingga $3,00 per juta token melalui arsitektur Mixture-of-Experts (MoE) dan lapisan perutean efisiensi tinggi.
Tiga pergeseran rekayasa struktural menjelaskan deflasi harga yang cepat ini. Pertama, arsitektur sparse Mixture-of-Experts telah menjadi pola desain standar baik bagi penyedia open-weights maupun komersial. Alih-alih mengaktifkan ratusan miliar parameter padat untuk setiap token yang dihasilkan, model modern seperti DeepSeek V3.2, Qwen3.5 Max, Llama 4 Maverick, dan Mistral Large 2 hanya mengaktifkan 32 hingga 45 miliar parameter pakar aktif dari total более dari 400 miliar parameter, sehingga memangkas operasi komputasi per token secara drastis tanpa mengorbankan kedalaman penalaran.
Kedua, caching konteks prompt (prompt caching) dan API batch asinkron telah menjadi mekanisme penagihan produksi standar di OpenAI, Anthropic, Google Vertex AI, dan DeepSeek dengan diskon 50% hingga 90% dari tarif input standar. Ketiga, kaskade perutean prompt hibrida memungkinkan gateway produksi mengarahkan 70% hingga 85% kueri klasifikasi dan ringkasan rutin ke model ringan di bawah $0,20 per juta token (seperti GPT-4.1 Nano atau Gemini 2.5 Flash-Lite), dan hanya meneruskan tugas rekayasa perangkat lunak multi-file yang kompleks ke model flagship.
Namun, pemimpin rekayasa harus mewaspadai jebakan penagihan baru pada model penalaran diperpanjang (seperti seri o OpenAI, penalaran GPT-5, Claude Extended Thinking, dan DeepSeek R1) yang menghasilkan ribuan token pemikiran internal (thinking tokens) yang ditagih dengan tarif penuh token output. Menggabungkan tolok ukur biaya tingkat tugas, perutean multi-penyedia, dan batas ketat `max_completion_tokens` adalah strategi paling efektif untuk anggaran infrastruktur AI 2026–2027.
Every dispatch published by the GetInfoUs Research Desk is cross-checked against primary government statutes, official provider documentation, and reproducible benchmark datasets before publication.
Related reading
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.