2026 में फ्रंटियर AI API कीमतों में 68% की गिरावट: ओपन-वेट्स MoE मॉडलों ने प्रोप्राइटरी फ्लैगशिप्स को दी कड़ी टक्कर
330+ फाउंडेशन मॉडलों की स्वतंत्र बेंचमार्क ट्रैकिंग से पता चलता है कि स्पार्स Mixture-of-Experts (MoE) आर्किटेक्चर, प्रॉम्प्ट कैशिंग और ओपन-वेट्स प्रतिस्पर्धा ने पिछले बारह महीनों में एंटरप्राइज़ LLM इनफरेंस लागत को दो-तिहाई से अधिक घटा दिया है।
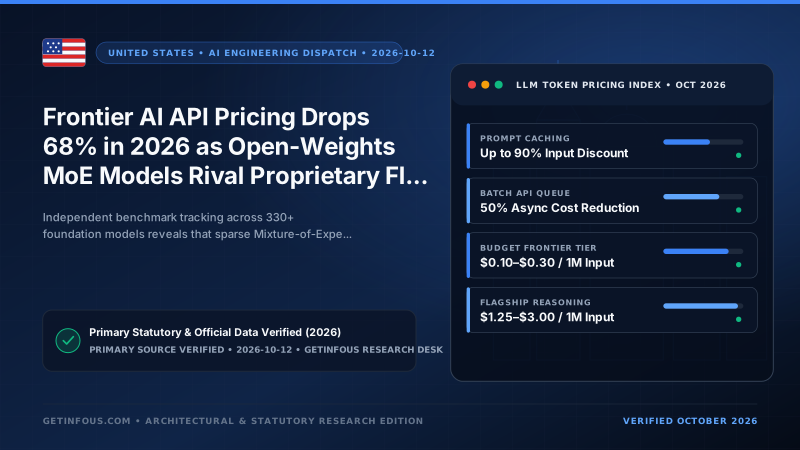
अक्टूबर 2026 में फाउंडेशन मॉडल API का मूल्यांकन करने वाली एंटरप्राइज़ आर्टिफिशियल इंटेलिजेंस टीमों के सामने बारह महीने पहले की तुलना में बिल्कुल अलग आर्थिक परिदृश्य है। GetInfoUs रिसर्च डेस्क द्वारा ट्रैक किए गए 330 फ्रंटियर और ओपन-वेट्स मॉडलों में MMLU-Pro पर 80+ स्कोर और SWE-bench Verified पर 65%+ समाधान दर प्राप्त करने के लिए आवश्यक औसत 3:1 मिश्रित API लागत साल-दर-साल लगभग 68 प्रतिशत गिर गई है। जिसके लिए पहले $15.00 से $75.00 प्रति मिलियन आउटपुट टोकन वाले प्रीमियम प्रोप्राइटरी एंडपॉइंट्स की आवश्यकता होती थी, उसे अब स्पार्स Mixture-of-Experts (MoE) आर्किटेक्चर के माध्यम से $0.40 से $3.00 प्रति मिलियन टोकन में निष्पादित किया जा सकता है।
तीन प्रमुख इंजीनियरिंग बदलाव इस तेज़ मूल्य गिरावट को स्पष्ट करते हैं। पहला, स्पार्स Mixture-of-Experts आर्किटेक्चर अब ओपन-वेट्स और कमर्शियल दोनों प्रदाताओं के लिए डिफ़ॉल्ट डिज़ाइन बन गया है। प्रत्येक जनरेट किए गए टोकन के लिए सैकड़ों बिलियन पैरामीटर सक्रिय करने के बजाय, DeepSeek V3.2, Qwen3.5 Max, Llama 4 Maverick और Mistral Large 2 जैसे आधुनिक मॉडल 400-बिलियन+ के कुल पूल में से केवल 32 से 45 बिलियन सक्रिय पैरामीटर ही उपयोग करते हैं, जिससे तर्क क्षमता बनाए रखते हुए प्रति टोकन कम्प्यूट लागत काफी कम हो जाती है।
दूसरा, कॉन्टेक्स्ट प्रॉम्प्ट कैशिंग और एसिंक्रोनस बैच API अब OpenAI, Anthropic, Google Vertex AI और DeepSeek में मानक बिलिंग तंत्र बन चुके हैं, जो इनपुट दरों पर 50% से 90% तक की छूट देते हैं। तीसरा, हाइब्रिड प्रॉम्प्ट राउटिंग कैस्केड की मदद से 70% से 85% सामान्य वर्गीकरण और सारांश क्वेरी को $0.20/1M से कम लागत वाले हल्के मॉडलों (जैसे GPT-4.1 Nano या Gemini 2.5 Flash-Lite) पर भेजा जाता है, और केवल जटिल सॉफ्टवेयर इंजीनियरिंग कार्यों को फ्लैगशिप रीजनिंग मॉडलों पर भेजा जाता है।
हालांकि, कम प्रति-टोकन कीमतों के साथ रीजनिंग मॉडलों (OpenAI o-series, GPT-5 रीजनिंग, Claude Extended Thinking और DeepSeek R1) में छिपे हुए 'थिंकिंग टोकन' बिलिंग का ध्यान रखना आवश्यक है, क्योंकि एक जटिल प्रश्न में 8,000 से 24,000 आंतरिक आउटपुट टोकन खर्च हो सकते हैं। इसलिए 2026-2027 के AI बजट के लिए मल्टी-प्रोवाइडर राउटिंग और सख्त `max_completion_tokens` बजट लागू करना सबसे प्रभावी रणनीति है।
Every dispatch published by the GetInfoUs Research Desk is cross-checked against primary government statutes, official provider documentation, and reproducible benchmark datasets before publication.
Related reading
Benchmark scores, token prices, and rate limits evolve rapidly as AI labs release model updates. Always verify current specifications and pricing on the official provider documentation.